


服务热线
名家专栏

名家专栏

写得太好了!建议所有做芯片设计的科研人员都去学一下,AI4EDA太关键了!
2026-11-07
193
AI4EDA是将人工智能技术(尤其是机器学习、深度学习和强化学习)应用于电子设计自动化(EDA)的前沿交叉领域,旨在应对后摩尔时代集成电路设计复杂度爆炸、设计周期长、人力依赖强等核心挑战。在具体应用中,AI已广泛渗透芯片设计的全流程:在逻辑综合与高层优化中,利用图神经网络学习门级网表的时序特征,并通过强化学习自动选择最优综合策略;在布局布线环节,深度强化学习可端到端学习宏单元摆放策略,卷积神经网络用于预测布线拥塞与时序违例,显著超越传统启发式算法;在时序与功耗分析中,机器学习回归模型替代高成本的SPICE仿真,实现10-100倍的快速分析;物理验证方面,图神经网络与变分自编码器能够高效检测版图热点并自动生成符合设计规则的修正方案;此外,AI还应用于参数化器件建模、设计空间探索与EDA超参数自动调优等方向。当前,Google的AlphaChip、Synopsys、Cerebrus、Cadence的AI驱动DRC等成果已证明,AI辅助设计可将功耗-性能-面积指标提升15%以上,同时将设计周期从数周压缩至数小时。近几年来,AI4EDA是在学术圈和工业界愈发引人注目,相关成果持续发表于DAC、ICCAD、TCAD等顶会顶刊,是学术创新与产业落地兼具的黄金研究方向。
001
专题目标
1.掌握Python编程技能和深度学习方法
掌握深度学习的理论、框架和模型,训练AI实战能力,包括常用的神经网络类型、Vim文本编辑能力、Python编程以及Pytorch神经网络框架,为AI在EDA领域的应用奠定扎实的能力基础。
2.熟悉集成电路设计自动化EDA流程
熟悉集成电路设计自动化EDA在芯片设计流程中各个阶段的应用,了解常用EDA算法的基本原理,能用Python实现基本的EDA算法,并通过本课程发现AI在EDA领域的应用机会点,为后续科研找到方向。
3.熟悉AI在芯片APR过程中的应用
熟悉芯片物理设计,即布局、时钟树综合和布线(APR)的具体流程和相关算法,并了解AI在APR过程中的应用场景和经典论文,学习AI在APR算法中的经典应用案例,并在上机实验中进行复现,对AI在EDA领域中的应用有深入的认识
4.掌握AI用于EDA建模的能力
能够使用AI模型对EDA领域的问题进行建模,通过集成电路 EDA 设计精英挑战赛的实战赛题,实际了解企业在AI4EDA领域的真实需求和难点问题,并在上机实验中学习如何使用AI算法对EDA领域的问题进行建模,为工作积累项目经验。(专题提供服务器使用)
02
讲师介绍
本课程主讲老师来自国内985重点高校,拥有两年海外留学经历,集成电路EDA电路设计自动化研究方向,参与多项国家自然科学基金面上项目。熟悉深度学习方法和EDA算法及相关软件的使用,具有丰富的编程经验和EDA工具使用经验,对深度学习方法应用于EDA物理设计流程有深入的研究和优秀的成果,参加了2022/2023/2024年集成电路 EDA 设计精英挑战赛,并在EDA领域期刊上发表了数篇论文。
本课程深入介绍了深度学习在EDA领域的众多应用,授课内容丰富。通过此次课程,学员能够快速上手深度学习方法,包括图神经网络、强化学习等,并掌握Python编程和Pytorch深度学习框架等代码能力。本课程覆盖了绝大多数AI在EDA领域的应用场景,安排了较多的上机实验,提供大量相关代码与示例教程,包括DreamPlace、OpenROAD和集成电路EDA 设计精英挑战赛的实战赛题等,帮助学员熟悉各种AI for EDA方法的使用,快速复现顶刊论文结果,从而对AI for Science在EDA方面的应用有更加深入的了解。
专题大纲
第一部分:EDA集成电路设计自动化和Python编程
核心目标:
(1)建立EDA与AI4EDA全局认知:熟悉芯片从Spec到Tape Out的完整设计流程,掌握后端物理设计(RTL到GDSII)的各阶段任务,理解AI技术在EDA领域的优势与发展脉络。
(2)熟练搭建高效开发环境:掌握Linux系统常用命令、Vim文本编辑器、iTerm/Xshell终端及Anaconda环境管理工具,学会使用超算服务器与Slurm作业调度系统。
(3)掌握数据科学与可视化开发基础:熟练运用Python语言基础、PyCharm及Jupyter Notebook IDE,并能使用Numpy、Pandas、Matplotlib等库完成数据处理与结果可视化。
(4)具备经典EDA划分算法编程能力:理解网表切分(Partition)机制,能够独立用Python编写实现Kernighan-Lin(KL)和Fiduccia-Mattheyses(FM)超图分割算法。
理论内容
(1)课程引言
①EDA设计自动化的基本概念
②AI4EDA——深度学习在EDA领域的应用和优势
③课程内容安排和参考资料
(2)芯片设计的流程和EDA的应用
①芯片设计的流程——从Spec到Tape Out
②EDA的历史和发展脉络
③EDA工具在后端物理设计中的应用——从RTL到GDSII
(3)AI4EDA的发展历程和概况
(4)Python编程基础
①Python编程语言介绍
②Python编程的优势
③常用的Python库——Numpy、Matplotlib和Scipy等
(5)Python编程实现超图分割算法
①超图分割算法应用于网表切分partition
②超图分割算法——从 Kernighan-Lin algorithm算法到Fiduccia-Mattheyses Algorithm
上机实验
(1)Linux系统的常用命令
①命令行终端软件——iTerm和Xshell
②ls/ll/cd/cp/mv/cat/pwd/less/tail/mkdir/touch等命令行操作
③vim文本编辑
(2)Python环境管理软件Anaconda的使用
①使用Conda命令创建环境、安装Python库
②使用Conda命令管理环境和环境的回溯
(3)Python编程语言基础和集成开发环境(IDE)的介绍
①数据类型、函数、类和对象、模块
②Pycharm软件的使用和常见用法
③Jupyter Notebook的使用
(4)Python实战
①条件语句,循环语句等
②Numpy数学运算库
③Pandas数据分析库
④Matplotlib数据可视化
(5)超算服务器和Slurm作业调度系统的使用
(6)Python进阶——使用Python实现Kernighan-Lin algorithm和Fiduccia-Mattheyses Algorithm超图分割算法
①KL/FM算法介绍和在EDA领域的应用
②KL算法的Python实现和效果展示
③FM算法的Python实现和效果展示
第二部分:AI4EDA——深度学习方法、Pytorch编程和TCAD仿真加速
核心目标
(1)融会贯通深度学习核心理论:深入理解神经网络基本结构、激活函数、前向/反向传播原理及万能近似定理,掌握FNN、CNN、RNN、GNN及ResNet残差网络的设计思想。
(2)掌握PyTorch框架全流程开发:熟练运用PyTorch进行张量计算、自动微分(Autograd)、GPU并行加速与模块化网络搭建,掌握深度学习模型的训练、调参及精度评估。
(3)掌握电路网表图建模与特征提取:学会利用NetworkX将电路网表转化为图结构数据,运用图神经网络(GNN)提取结构特征并预测电路对称性等性质。
(4)具备AI加速TCAD器件建模的实战能力:结合自动微分与前馈神经网络(FNN),针对NMOS/PMOS电学性质建模,并在EDA设计精英挑战赛实战中完成器件模型构建与工艺参数优化。
课程内容
(1)深度学习基本理论
①人工神经网络与万能近似定理
②神经元的基本结构与功能
③常见的激活函数及其特点
④前向传播与反向传播的基本原理
(2)深度学习的发展历程和优势
①神经网络的发展历程:从全连接到深度学习大模型
②神经网络的常见分类:FNN、CNN、RNN和GNN
③深度神经网络入门——以ResNet残差神经网络为例
④常用的深度学习库——Pytorch简介
(3)AI4EDA初探——面向 TCAD 仿真的通用器件模型算法和实现
①TCAD仿真和器件建模的背景
②深度学习的梯度计算和Pytorch自动微分
③深度学习用于构造NMOS/PMOS器件模型和工艺参数优化
上机实验
(1) Pytorch深度学习框架
①Pytorch的安装和调用GPU训练模型
②Pytorch的基本功能与模块化设计
③Pytorch和Numpy对比
④使用Pytorch搭建简单的神经网络模型
⑤神经网络的训练流程
(2)深度学习项目实践Toy Project:ResNet残差网络用于手写数字识别
①手写数据集的准备
②ResNet模型的训练、测试和评估
③深度学习模型训练的超参数设置和调参
(3)图神经网络实战——使用GNN对网表进行建模、特征提取和性质预测
①NetworkX库介绍
②网表转化为图结构数据过程讲解
③使用图神经网络对电路对称性进行预测
(4)2022年集成电路 EDA 设计精英挑战赛赛题实战:面向 TCAD 仿真的通用器件模型算法和实现
①赛题背景和要求
②基于前馈神经网络FNN和跨导概念对NMOS/PMOS电学性质进行建模
③Pytorch的神经网络自动微分功能
④深度学习模型的训练、推理和精度评估
第三部分:AI4EDA——APR Placement布局算法
核心目标:
(1)深刻理解后端物理设计与布局理论:掌握APR流程中的静态时序分析(STA)、形式验证(FM)、LVS及时序收敛概念;掌握布局(Placement)在Global与Detailed阶段的核心优化目标(HPWL线长、拥塞度、PPA)及评估模型。
(2)掌握传统布局求解算法与代码实现:理解Min-Cut、模拟退火(SA)及解析法布局原理;能够使用Python动手实现基于模拟退火算法的Macro Placement布局器。
(3)掌握图卷积(GCN)与强化学习(RL)前沿应用:理解图卷积消息传递机制,掌握强化学习(DQN)机制;深入学习AlphaChip(Nature 2021)、扩散模型布局(PMLR 2025)等前沿论文。
(4)具备强化学习与开源AI布局工具实战能力:使用PyTorch实现DQN解决控制任务,并掌握现代基于深度学习的高性能布局工具DREAMPlace的源码解读、环境部署及实际测试。
课程内容
(1)后端物理设计流程简介
①Netlist Partition、Chip Planning、Pin Assignment和Powerplan规划
②Placement、CTS和Route(APR)
③形式验证FM和版图一致性验证LVS
④静态时序分析STA、时序收敛和电源完整性PI
⑤时序的基本概念:建立时间和保持时间
(2)芯片Placement的过程——从global placement到detailed placement
①芯片布局的目标——线长、拥塞度和PPA
②线长评估模型:HPWL半周线长和RMST最小生成树
③时序评估模型:Elmore模型和查找表LUT
④Global placement——粗粒度全局布局
⑤Detailed placement——细粒度详细布局
(3)Placement相关算法
①Min-Cut最小隔算法
②基于模拟退化SA算法的全局布局方案
③基于解析法的布局方案:仿电场、密度和时序
④布局问题的求解——基于梯度下降的数值求解算法
(4)图卷积神经网络
①图数据结构和图卷积神经网络简介
②图神经网络应用于电路和网表建模
③深入理解图卷积——消息传递过程
④图卷积和图像卷积的区别
(5)强化学习简介
①强化学习的基本思想:智能体、环境、动作、奖励和状态
②强化学习的机制和DQN算法
③强化学习的应用场景和在EDA领域的应用
(6)深度学习用于芯片Placement布局优化
①基于扩散模型的Macro Placement方案(PMLR 2025)
②Google AlphaChip:最早用于芯片布局的深度强化学习方案(Nature 2021)
③DREAMPlace:基于深度学习的VLSI布局工具(ICCAD 2023)
④RL_PCB:基于强化学习的板级布线算法(DATE 2024)
上机实验
(1)Python编程实现基于模拟退火的Placement算法
①模拟退火原理讲解
②基于模拟退火的Macro Placement算法
③Python代码编写和效果测试
(2)强化学习实战——DQN应用于倒立摆CartPole-v1任务
①DQN原理解读
②Pytorch编程实现利用强化学习框架解决倒立摆CartPole-v1问题
③模型训练和效果展示
(3)DREAMPlace:基于深度学习的VLSI布局工具(ICCAD 2023)
①DREAMPlace源码讲解
②DREAMPlace的安装和部署
③DREAMPlace的使用和测试
第四部分:AI4EDA——APR CTS时钟树综合算法
核心目标:
(1)理清芯片时钟树综合(CTS)的核心机制:掌握片上时钟产生机制、skew(偏斜)、latency(延迟)、 useful skew等关键概念,明确Cluster(聚类)与Balance(平衡)阶段的优化目标(DRC、Timing)。
(2)掌握经典CTS算法与Python复现:理解K-means聚类、Steiner树/FLUTE布线算法及DME延迟平衡算法;能使用Python动手实现基于DME算法的时钟树Buffering与Balance过程。
(3)掌握生成式与图神经网络在时序预测中的应用:理解GAN在时钟树优化(TCAD 2022)、GNN在时序预测(DAC 2022)及开源iCTS框架的技术路线,掌握华为τ定律与逻辑折叠等进阶概念。
(4)具备开源物理设计工具与顶会论文复现能力:掌握开源EDA工具OpenROAD及其TritonCTS引擎的使用;能够基于PyTorch完整复现DAC 2022顶刊论文中的图神经网络时序预测全流程。
课程内容
(1)片上时钟和时钟树简介
①时钟的产生和时钟源
②时钟树的基本概念:skew和latency
③时钟树的结构和作用
(2)芯片CTS时钟树综合的过程——从Cluster到Balance
①CTS的目标——clock latency、skew、DRC和timing
②Cluster过程——寄存器聚类、DRC和时钟树构造
③Balance过程——时钟树打平和结构优化
(3)CTS的相关算法和进阶概念
①寄存器分组和聚类:K-means和层次聚类
②延迟平衡:Balance和DME算法
③时钟布线:Steiner树和FLUTE算法
④零偏斜树ZST、有界偏斜树BST和有用偏斜useful skew
(4)深度学习应用于时钟树综合和开源的CTS框架
①生成对抗网络GAN应用于时钟树预测和优化(TCAD 2022)
②图神经网络应用于时序预测(DAC 2022)
③iCTS框架(TCAD 2025)
(5)进阶内容:华为定律和逻辑折叠
上机实验
(1)Python编程实现DME延迟平衡算法
①基于DME的时钟树buffering和balance过程
②Python代码编写和效果测试
(2)OpenROAD
①OpenROAD软件的安装
②TritonCTS——OpenROAD的CTS引擎介绍
③在OpenROAD上运行CTS任务
(3)论文复现:基于图神经网络的时序预测方法(DAC 2022)
①数据集下载和预处理
②Pytorch编写图神经网络和代码解读
③图神经网络的训练和时序预测
第五部分:AI4EDA——APR Route绕线算法、逻辑综合和芯片电源完整性
核心目标:
(1)掌握绕线(Route)与逻辑综合基础理论:掌握从Global Routing到Detailed Routing的优化目标,理解Maze-Routing、A*搜索(PathFinder)及整数线性规划(ILP)算法原理。
(2)掌握AI算法在绕线与综合中的应用:学习AI预测可布性(RouteNet)、异步强化学习搜索绕线顺序及DR-Guide生成式AI框架;理解深度强化学习在逻辑综合(DRiLLS)中的应用。
(3)掌握Transformer架构与生成式AI建模:深入理解Transformer机制与Self-Attention原理,并能够使用PyTorch独立搭建与实现Transformer网络架构。
(4)具备电源完整性(IR Drop)预测实战与布线器开发能力:用Python实现基于DFS/BFS/A*算法的迷宫布线器;在EDA设计精英挑战赛实战中,提取SoC版图特征,并使用PyTorch搭建基于Inception+U-Net的深度卷积网络,实现静态压降(IR drop)的高精度预测。
课程内容
(1)芯片绕线routing过程:从global routing到detailed routing
①芯片布线基本概念:pitch、track、layer和线长
②芯片布线的优化目标——总线长、DRC、SI和PPA
③Global routing——G-cell和全部布线
④Detailed routing——详细布线
(2)Routing的相关算法
①Maze-Routing algorithm——基于图的迷宫算法
②基于A* 搜索的PathFinder算法
③整数线性规划算法求解routing问题
(3)深度学习应用于芯片绕线和开源的绕线算法
①RouteNet——AI应用芯片可布线性预测的经典工作(ICCAD 2018)
②异步强化学习框架应用于详细布线的线网顺序探索(DATE 2021)
③DR-Guide——应用于详细布线的生成式AI框架(MLCAD 2025)
(4)深度学习应用于芯片电压降IR drop预测
①芯片电源完整性和IR drop简介
①IR drop预测相关的文献和深度学习建模方法
②深度卷积神经网络应用于芯片建模和电压降预测
③GoogleNet和Inception模块
(5)深度学习应用于逻辑综合Logic Synthesis
①逻辑综合的基本概念
②DRiLLS——深度强化学习用于逻辑综合(ASP-DAC 2020)
(6)Attention is All You Need——Transformer模型
①Transformer原理讲解
②Transformer架构在AI模型中的应用
上机实验
(1)Python编程实现一个简单的布线器
①Maze routing算法介绍
①Python编程实现基于深度优先搜索、广度优先搜索和A*算法的布线器
②布线算法效果测试和可视化
(2)OpenROAD实战
①TritonRoute——OpenROAD的route引擎介绍
②使用OpenROAD实现布线任务
(3)Transformer实战
①Transformer原理介绍
②Pytorch实现Transformer架构
(4)2024年集成电路 EDA 设计精英挑战赛赛题实战:基于机器学习的 SoC 电源网络静态压降预测
①芯片版图特征提取和建模;
②Pytorch编程实现Inception模块
③Pytorch搭建基于Inception模块的U-net模型
④模型的训练、推理和预测精度
免责声明:本文采摘自"老虎说芯",仅代表作者观点,如有侵权或异议请联系我们删除。
HBF 到底是什么?把 NAND 做成“高带宽内存”,Sandisk 想解决 AI 推理的容量墙
2026-11-07
240
过去两年,AI 芯片讨论里最热的关键词之一是
HBM。
原因很简单:GPU 算力增长得太快,模型也越来越大,真正限制系统性能的东西,越来越不是"算不动",而是数据喂不进去、模型装不下。
但 HBM也有一个很现实的问题:它很快,却不便宜;带宽很高,但容量扩展并不轻松。
于是 Sandisk 提出了一个很有意思的方向:HBF,High Bandwidth Flash,高带宽闪存。
它想做的事情听上去甚至有些"反常识":
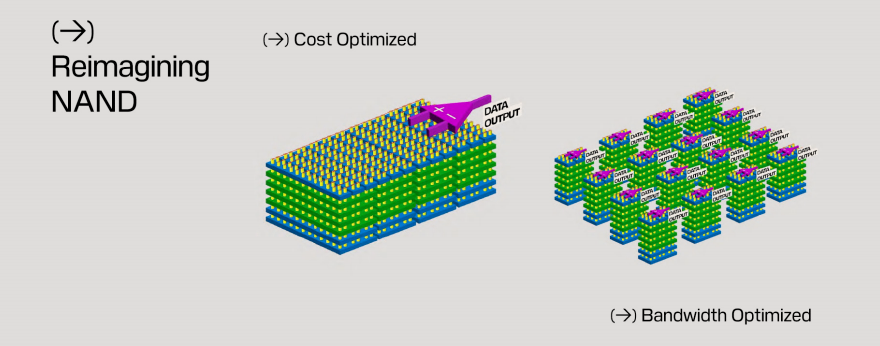
既然 NAND 的容量大、成本低,为什么不能像 HBM 一样,把大量 NAND die 高度并行起来,再通过先进封装和专用逻辑,把总带宽堆到 TB/s?
这就是 HBF 的核心思路。
但理解 HBF 最重要的一点,是不要被"1.6 TB/s"这样的数字带偏。
HBF 并不是把 NAND 变成了 HBM。
它真正有价值的地方,是试图在 HBM 和传统 SSD 之间,创造一个新的 memory tier。
一、AI 推理现在缺的,不只是带宽,而是"高带宽的大容量"
对于传统 GPU,内存系统大体可以理解成这样:
text
GPU Compute │ ▼HBM │ ▼DDR / CXL Memory │ ▼SSD / NAND
越靠近 GPU,速度越快、延迟越低,但容量越小、成本越高。
HBM 处在这个金字塔最靠近计算单元的位置。它最大的优势,是极高带宽和较低访问延迟。
问题在于,大模型推理正在同时要求两件过去很难兼得的事情:
第一是带宽。
GPU 每生成一个 token,都需要不断读取模型权重、KV Cache,以及各种中间数据。
第二是容量。
几百亿、几千亿参数模型,尤其是 MoE 模型,工作集可能大到单颗 GPU、甚至单台服务器的 HBM 根本装不下。
Sandisk 在 HBF 的技术资料里把这个矛盾说得非常直接:AI inference 同时需要更大的带宽和更高的容量,而其认为 HBM 在容量、功耗和成本方面存在扩展约束。HBF 的目标,是用 NAND 提供 HBM 约 8~16 倍的容量,同时保持相近的带宽等级。
这句话听起来很有冲击力。
但真正值得研究的不是"8~16 倍",而是:
NAND 明明比 DRAM慢很多,为什么还能做出 TB/s 级带宽?
这恰恰是 HBF 最值得讨论的地方。
二、HBF 的秘密:不是让一颗 NAND 变快,而是让大量 NAND 同时工作
先讲一个非常重要的概念:
单颗存储介质的延迟,和整个存储系统的总带宽,是两回事。
假设一条高速公路上的一辆卡车跑得不快。
提高运输能力有两种办法。
一种办法,是让卡车本身跑得更快。
另一种办法,是同时修几百条车道,让几百辆卡车并行运输。
HBM 更接近前一种思路加大量并行:
DRAM 单次访问本身已经很快,同时又拥有极宽的接口。
而 HBF 的思路,更像把 NAND 的第二条路走到极致:
单个 NAND die 依然不是低延迟器件,但同时让大量 die、plane、channel 工作,最终把 aggregate bandwidth 做得非常高。
因此,理解 HBF 最核心的公式不是:
text
NAND ≈ HBM
而是:
text
HBF 总带宽≈ NAND Die 吞吐量× Die 并行度× Plane / Channel 并行度× 高速接口效率× Controller 调度效率× 封装互连效率
这也是为什么 HBF 本质上是一项系统工程,而不只是 NAND cell 本身的创新。
三、CBA:HBF 背后的关键技术之一
Sandisk 在材料里反复强调一项技术:
CBA,CMOS directly Bonded to Array。
简单理解,就是把负责控制、I/O 和外围逻辑的 CMOS,与 NAND Array 通过键合方式进行组合,而不是像传统 NAND 那样让所有逻辑和存储阵列在布局上互相妥协。
这种架构的价值,是可以分别优化:
text
NAND Array→ 追求容量和密度Logic / CMOS→ 追求高速 I/O、控制逻辑和并行能力
然后再将两者连接起来。
Sandisk 将 CBA、先进 die stacking 和热机械设计列为 HBF 的核心基础,并称其 16-die 堆叠需要解决 die warpage、stress 和 thermal conductivity 等问题。HBF 同时保留 NAND 的非易失性,因此断电后数据不会丢失,也不需要 DRAM 那样的 refresh power。
这也是 HBF 与"把普通 SSD 接到 GPU 上"最大的不同。
普通 SSD 的数据路径可能是:
text
NAND ↓Flash Controller ↓PCIe ↓GPU I/O ↓HBM ↓GPU Core
而 HBF 想把 flash 进一步推近 GPU:
text
HBF NAND Array ↓HBF Logic / Controller ↓高带宽封装接口 ↓GPU / xPU
也就是说,它试图从传统 storage,向 memory-like tier 靠近。
四、第一代 HBF 的数字确实很激进:512GB、1.6TB/s
Sandisk 给出的第一代 HBF 参数是:
| 指标 | HBF Gen 1 || -------------- | ---------: || 单 die 容量 | 256Gb || Stack die 数 | 16 || 单 stack 总容量 | 512GB || Read Bandwidth | 1.6TB/s || 介质 | NAND Flash || 非易失性 | 是 |
材料同时声称,其封装尺寸、功耗 profile 和 stack height 接近 HBM4。
这个容量是什么概念?
256Gb 相当于 32GB。
16 个 die:
text
32GB × 16 = 512GB
如果一个 accelerator package 上可以部署多个 HBF stack,那么理论上单颗 accelerator 周围就可能出现 TB 级本地存储容量。
Sandisk 在第二页的示意图中,就展示了从约 192GB HBM 配置,扩展到超过 3TB、甚至约 4TB 总内存容量的概念性配置。
这里才是 HBF 真正的杀手锏。
不是单纯的 1.6TB/s。
而是:
几百 GB 乃至 TB 级容量,同时仍然拥有 TB/s 级 aggregate read bandwidth。
传统 SSD 容量当然也能做到 TB 级。
问题是传统 SSD 到 accelerator 的路径太长、接口带宽太低。
HBM 的带宽非常高,但容量昂贵。
HBF 正试图填补两者之间的巨大空档。
五、但有一个必须讲清楚的问题:1.6TB/s ≠ HBM
这是理解 HBF 最重要的一部分。
Sandisk 自己其实在脚注里已经承认:
HBF 相比 HBM 具有 higher latency 和 larger page size。
也就是说,HBF 的访问粒度和延迟特征依然与 HBM 不同。
因此:
text
HBF 1.6TB/s
绝不能简单理解成:
text
HBF 的访问行为 = 1.6TB/s 的 HBM
两者解决的问题不同。
举个例子。
如果 GPU 连续读取一个巨大的模型权重矩阵:
text
地址 A地址 A+1地址 A+2地址 A+3……
访问十分连续。
这时可以提前把 NAND page 读出来,同时让大量 NAND die 并行工作。
HBF 很可能表现得非常好。
但如果 GPU 的访问是:
text
地址 A突然跳到地址 Z然后访问地址 M再访问地址 B
而且每次只需要几十个 byte。
那么 NAND 较大的 page size 和更高的 read latency 就会暴露出来。
所以,HBF 的真正问题并不是:
"带宽有没有 1.6TB/s?"
而是:
真实 GPU workload 能不能持续产生足够大的并行请求,把这 1.6TB/s 吃满?
这两个问题的区别非常大。
六、Sandisk 的"只比无限容量 HBM 慢 2.2%",应该怎么理解?
HBF 资料里最容易被传播成标题党的数字,大概就是这个:
HBF 性能只比 unlimited-capacity HBM 低 2.2%。
这个数字必须看脚注。
它并不是一个完整 HBF 芯片在服务器里运行真实模型得到的公开 benchmark。
Sandisk 明确说明,这是internal testing and simulation。
测试对象是:
Llama 3.1 405B
模型权重:
8-bit pretrained weights
而且:
one kernel is executed on the xPU performance model at a time。
更重要的是,为了比较访问性能,其模拟中的 HBM 被假设成容量无限,也就是说,这个实验刻意没有让 HBF 的容量优势参与比较。
所以这个结果能证明什么?
可以证明:
在一个以读取大模型权重为主、访问模式适合 HBF 的 inference simulation 中,较高 NAND latency 和更大的 page size 并没有造成严重性能下降。
这是一个值得重视的结果。
但它不能证明:
text
HBF = HBM
也不能证明:
text
所有 AI inference workload 只慢 2.2%
更不能证明 training 也可以如此。
七、HBF 最适合的,其实是"模型权重"
如果从 workload 而不是产品宣传出发,HBF 最自然的应用对象其实很清楚:
LLM Weights
原因是模型权重具有三个非常适合 HBF 的特点。
第一,容量巨大。
第二,推理时绝大部分权重是读多写少,甚至基本不写。
第三,大量 GEMM/GEMV 操作具有较好的 streaming 特征,可以做 prefetch,也比较容易制造并行度。
比如一个 405B 参数模型。
如果使用 INT8:
text
405B parameters × 1 byte≈ 405GB
理论上,一颗 512GB 的 HBF stack 就已经接近能容纳整个模型权重。
这会带来非常重要的系统变化。
今天如果 HBM 放不下模型,通常只有几种办法:
text
把模型拆到更多 GPU ↓增加 NVLink / Network 通信或者把权重放 DDR / SSD ↓不断搬进 HBM
而如果 accelerator 周围拥有数百 GB 乃至 TB 级 HBF:
text
Model Weights ↓ HBF ↓ GPU Compute
很多原本因为"容量不够"而发生的数据搬运,就可能消失。
这很可能比单纯提高 NAND 的峰值带宽更有价值。
八、真正值得关注的 HBF 场景,可能是 MoE
HBF 在 MoE 模型上的潜力甚至可能比普通 dense model 更有意思。
MoE 的特点是:
模型总参数量巨大,但每一个 token 实际只激活其中少数 expert。
假设系统拥有大量 expert:
text
Expert 1Expert 2Expert 3...Expert 256
如果全部放 HBM,非常浪费昂贵容量。
但如果放 SSD,需要时再读取,又可能太慢。
一种更合理的层级可能变成:
text
GPU │HBM │HBF │SSD
把最热门的 expert 放在 HBM。
大量冷一些的 expert 常驻 HBF。
再由软件预测下一批 token 需要哪些 expert,提前 prefetch。
这种情况下,HBF 不需要拥有 HBM 一样的单次访问 latency。
只要:
text
预测足够准确+prefetch 足够早+并发度足够高+bandwidth 足够大
就有可能把 NAND latency 隐藏掉。
这才是 HBF 真正值得关注的架构方向。
九、KV Cache 就没有那么简单
看到"512GB 高带宽 NAND",很多人自然会想到 KV Cache。
容量上确实非常诱人。
长上下文推理越来越多以后,KV Cache 可以达到几十 GB、几百 GB,甚至更高。
但 KV Cache 和模型权重有本质区别。
模型权重近似:
text
ReadReadReadRead
KV Cache 则不断发生:
text
Write new KVRead previous KVWriteReadWriteRead
这就触碰到了 NAND 最大的弱点:
write latency、erase granularity 和 endurance。
Sandisk 在材料里特别强调 HBF 将使用先进 reliability 和 redundancy management 来解决 endurance 和高温数据中心环境的问题。
但这只能说明厂商意识到了问题。
资料并没有给出:
P/E cycle、DWPD、TBW、write amplification、随机写性能、写延迟或 tail latency。
所以目前更合理的判断是:
HBF 对模型权重的适配度明显高于 KV Cache。
KV Cache 能否成为核心 workload,要等真正的写性能和 endurance 数据。
十、Training 更不能直接套用 inference 的结论
HBF 的资料非常明确地把目标定位在:
AI inference。
这是合理的。
Training 对 memory system 的要求明显更加苛刻。
训练不仅要读 weights,还要处理:
text
WeightsActivationsGradientsOptimizer States
而且不断发生写入和更新。
这意味着 memory workload 更接近:
text
Read + Write + Random Access + Fine-grained Access
而不是纯粹的 streaming read。
这恰恰是 NAND 相对于 DRAM 最不利的区域。
因此,就目前公开材料而言,最合理的位置仍然是:
text
TrainingHBM >>> HBFInference WeightsHBF 很有潜力Inference KV Cache有潜力,但存在明显疑问
不能因为 HBF 在一个 inference simulation 中表现接近 HBM,就进一步推出:
"以后 AI GPU 不需要 HBM 了。"
这个结论现在还远远站不住脚。
十一、所以 HBF 到底是 HBM Killer 吗?
目前看,我认为答案更接近:
不是 HBM Killer,而是 HBM Augmenter。
实际上 Sandisk 第一页自己的架构图就使用了"Augmenting HBM Memory with NAND Flash for AI Inference Workloads"这样的定位。
从 memory hierarchy 看,HBF 最合理的位置可能是:
text
Latency ↓ Cost/bit ↑ GPU Registers │ SRAM / Cache │ HBM │ ┌──────── HBF ────────┐ │ DDR / CXL │ SSD Capacity ↑ Cost/bit ↓
它的位置非常关键。
它不是传统 SSD。
因为其目标带宽和封装位置明显更靠近 accelerator。
它也不是传统 HBM。
因为 NAND 的 latency、page size、写特性仍然存在。
所以 HBF 更像一种:
Near-Compute High-Bandwidth Capacity Tier
中文可以理解为:
靠近计算单元的高带宽容量层。
如果这个 tier 能成立,其系统意义其实可能比"替代 HBM"更大。
十二、为什么几百 GB 的 HBF 可能比更快的 HBM 更值钱?
AI 系统里有一个经常被忽略的问题:
很多时候,GPU 数量不是由算力决定的,而是由内存容量决定的。
比如一个模型因为权重太大,本来需要:
text
8 GPUs
但真正计算时:
text
每张 GPU 都没跑满
只是因为模型必须拆开放。
这时增加更多 GPU,其实是在"买 HBM"。
如果 HBF 能把单 accelerator 可访问容量从几百 GB 提高到 TB 级,就有可能出现这样的变化:
text
Before:更多 GPU→ 更多 HBM→ 更多互联→ 更大功耗→ 更高成本After:更少 GPU+HBM+大量 HBF
那么真正下降的就不仅仅是 memory cost。
还可能包括:
GPU 数量、网络交换机、NIC、板级功耗以及集群通信开销。
这才是 HBF 真正可能改变 AI economics 的地方。
十三、最终评价 HBF,不能只看 TB/s,要看 $/token
对于 AI 基础设施而言,最重要的指标最终不是:
text
TB/s
甚至不是:
text
GB
而是:
text
$/token
HBF 能否降低 $/token,大概取决于这样一条链条:
text
更多模型可以驻留在本地 ↓减少 SSD / Host Memory 搬运 ↓减少模型切分和 GPU 间通信 ↓更少 GPU 即可运行大模型 ↓GPU utilization 提高 ↓系统成本 / 功耗下降 ↓$/token 下降
注意,这里面任何一个箭头断掉,商业价值都会大幅缩水。
比如 HBF 容量虽然很大,但实际访问 latency 导致 GPU 经常 stall:
text
GPU 算力 ↓等待数据 ↓等待数据 ↓等待数据
那么 512GB 就只是"装得下",而不是"跑得快"。
所以:
模型能放进去,与模型能高效运行,是两件完全不同的事情。
十四、HBF 目前最大的未知数,不是容量,而是"有效带宽"
Sandisk 已经公布 1.6TB/s。
但对于架构师而言,我反而更关心另外一些数字:
典型 read latency 和 P99/P999 tail latency 是多少?
1.6TB/s 是多大 request size 下测出来的?
顺序访问还是随机访问?
有多少并发 request?
最小有效访问粒度是多少?
NAND page size 是多少?
GPU cache miss 如何映射成 NAND transaction?
ECC 位于哪里?
controller 有多大 SRAM?
是否存在 read disturb、GC 或 background management?
write bandwidth 和 endurance 到底是多少?
16-die stack 的热阻和良率如何?
多个 HBF stack 同时跑满后,package power 会是多少?
这些问题才真正决定:
text
Peak Bandwidth ↓Effective Bandwidth ↓GPU Delivered Performance
中间会损失多少。
而这些数据,目前这份 fact sheet 并没有给出来。
十五、2TB/s、3.2TB/s 和 1.5TB:先把它们看成 Roadmap
Sandisk 也公布了 HBF 后续规划。
Gen 2 预计 read bandwidth 超过 2TB/s,容量最高达到 1TB;
Gen 3 预计达到 3.2TB/s,容量最高达到 1.5TB。
同时功耗目标分别下降到 Gen 1 的 0.8× 和 0.64×。
如果这些数字真正实现,HBF 会非常有意思。
但必须强调:
这是 projected / expected roadmap,不是量产 benchmark。
尤其是 1.5TB stack + 3.2TB/s 这种组合,背后同时要求:
text
NAND scaling+die parallelism+高速 logic+advanced bonding+thermal+yield+controller+ECC+package power
任何一个环节掉链子,都可能影响最终产品。
所以目前不能把 Gen 3 roadmap 当成已经存在的器件。
十六、从产业化角度看,HBF 还处在哪个阶段?
这份资料中有一个非常容易误读的地方。
Sandisk 的 BiCS NAND 和 CBA 基础技术本身具有量产基础。
但这并不等于:
text
HBF 已经成熟量产
目前材料明确提供的,是产品架构、目标规格,以及部分 internal testing / simulation。
尤其是"与 unlimited HBM 相差 2.2%"的结果,Sandisk 自己明确注明属于内部测试和 simulation。
所以从产业成熟度角度,更稳妥的判断应该是:
text
Concept ✓Architecture ✓Specification ✓Simulation ✓First Silicon 需要进一步确认Sample 需要确认Qualification 尚无充分公开信息Mass Production 不能从这份材料判断
这和"BiCS NAND 已经大规模制造"完全是两个层次的问题。
十七、真正决定 HBF 成败的,其实只有一个问题
把所有技术细节都拿掉以后,HBF 的命运最终取决于:
能不能让 GPU 感觉自己访问的是一个"足够快的大容量 memory tier",而不是一个"非常快的 SSD"。
二者只有一线之隔。
如果最终表现是:
text
512GB1.6TB/s Peak但实际 AI workload 只有几百 GB/s而且 GPU 经常等待 NAND latency
那么它很难成为核心 memory tier。
但如果通过:
text
Massive parallelism+Prefetch+Large sequential reads+Caching+Software scheduling+Workload locality
真正把 NAND latency 隐藏掉,那么 HBF 就可能找到一个非常独特的位置。
结语:HBF 真正值得关注的,不是"HBM 的替代品",而是一个新的内存层
HBF 最吸引人的地方,并不是 Sandisk 把 NAND 做到了 1.6TB/s。
而是它提出了一个越来越重要的问题:
在 HBM 和 SSD 之间,是不是缺少一种新的 memory tier?
今天的 AI memory hierarchy 中:
HBM 很快,但贵、容量有限。
NAND 很便宜、容量巨大,但离 GPU 太远。
HBF 的赌注就是:
利用 NAND 的密度和成本优势,通过极端并行、CBA、先进封装和专用 controller,把 flash 推到足够靠近 GPU 的位置。
如果成功,它未必会消灭 HBM。
未来反而可能出现:
text
GPU / xPU │ Cache │ HBM │ HBF │ CXL / DDR │ SSD
HBM 负责最热、最敏感的数据。
HBF 负责超大模型权重和较冷的大容量工作集。
SSD 则继续承担真正的持久化存储。
这可能才是 HBF 最合理、也最有价值的未来。
因此,对 HBF 最值得提出的问题,不是:
"NAND 能不能打败 HBM?"
而是:
它能否在真实 AI inference workload 中,以比 HBM 更好的容量和成本、又以远高于 SSD 的可用带宽,形成一个长期存在的新 memory tier?
从 Sandisk 目前公布的架构看,这个方向在系统层面是成立的,而且对超大模型 inference 尤其值得关注。
但从 1.6TB/s 的规格数字,到真正降低 $/token,中间仍然隔着 latency、访问粒度、controller、ECC、endurance、thermal、yield、software stack 和真实 workload benchmark 这一整条产业链。
HBF 最精彩的故事,可能才刚刚开始。免责声明:本文采摘自"老虎说芯",仅代表作者观点,如有侵权或异议请联系我们删除。
手机影像开始卷“一次曝光”:从 SCC90XS 看懂 LOFIC HDR® 3.0
2026-11-07
252
这几年,手机影像最容易被用户感知的参数,始终是两个字:更大。
传感器越做越大,像素从5000万来到1亿、2亿,镜头焦段越来越完整,计算摄影也越来越复杂。
但真正拿手机去拍一场演唱会、一次日落,或者夜晚街头快速经过的人和车,会发现另一些问题并不会因为像素增加自动消失。
夕阳保住了,人脸可能变暗;
人物提亮了,背后的天空和灯牌又容易过曝;
静止场景的 HDR 尚且容易处理,一旦人开始跑、车开始动,或者进入连续视频拍摄,多帧之间的时间差又可能变成重影、拖影和明暗边界的不自然。
所以,当手机影像进入 2 亿像素时代后,新的问题已经不是"还能不能看得更细"。
而是:
在按下快门的那个瞬间,一颗传感器究竟能接住多少真实的光。
这也是 2026 年 LOFIC开始频繁出现在旗舰手机 CIS 讨论中的原因。
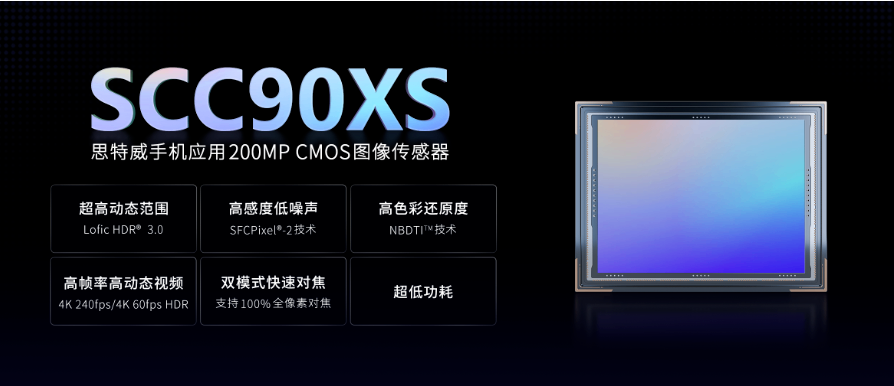
根据本次品牌提供信息,Xiaomi 18 Pro Max 主摄采用思特威 SCC90XS。小米官方公开页面已经确认,这颗主摄采用 2 亿像素、1/1.28 英寸传感器,并将 LOFIC 高动态技术列为其核心影像能力之一。
但如果只是把 SCC90XS 理解成"又一颗 2 亿像素传感器",其实会错过它真正有意思的地方。
它更值得观察的,是另一组组合:
2 亿像素、0.61μm 小像素、22nm Stack,以及 Lofic HDR® 3.0。
LOFIC 其实不是"新技术"
先把一个概念说清楚。
LOFIC 全称是 Lateral Overflow Integration Capacitor,横向溢出积分电容。
它不是某一家公司的通用技术名称,也不是 2026 年才出现的营销概念。
早在 2005 年的 ISSCC上,研究人员就已经发表过利用 LOFIC 实现 100dB 动态范围 CMOS 图像传感器的研究;2008 年的 IEEE Journal of Solid-State Circuits 论文,又进一步讨论了通过 LOFIC 同时获得高转换增益和大满阱容量的问题。到 2021 年,相关研究已经把两级 LOFIC 架构推进至超过 120dB 的单曝光动态范围。
所以问题并不是"LOFIC 是什么新发明"。
真正的问题是:
为什么一项存在了二十年的传感器架构,直到今天才越来越适合进入旗舰手机?
答案要从 CIS 最基本的矛盾说起。
一个像素既想"听见耳语",又要扛住"巨响"
可以把 CMOS 图像传感器里的每一个像素,想象成一个接雨水的容器。
光照到光电二极管后,被转化为电子。
光越强,产生的电子越多。
在暗光环境里,我们希望像素对很少的电子也足够敏感。换句话说,它必须能"听见很轻的声音"。
但到了太阳、LED 招牌、汽车大灯这样的强光场景,又希望像素能装下足够多的电子,不要轻易饱和。
问题就在这里。
高灵敏度和大容量,本身存在天然的设计张力。
如果一个像素的"杯子"太小,很少的光就能产生明显信号,但强光很快就会把它装满;
如果一开始就设计成一个巨大的"水桶",虽然不容易溢出,但微弱信号又会更难被精细地辨认。
传统 CIS 工程里,转换增益、满阱容量、读取噪声和动态范围一直在寻找平衡。
LOFIC 的思路非常直观:
不要只准备一个杯子。
在正常光照时,光电二极管按照高灵敏度路径工作。
当光电二极管逐渐接近饱和,多出来的电子并不是直接丢掉,而是继续溢流到旁边额外设计的积分电容里。
也就是说,弱光信号依然可以用高增益方式精细读取;而遇到很亮的区域,额外电容又提供了更大的电荷容纳空间。
IEEE 对 LOFIC 的描述正是如此:把光电二极管饱和后溢出的电子,在同一次曝光内继续积分到额外电容中,从而让转换增益和满阱容量可以更独立地设计。
这就是 LOFIC 最核心的价值。
它并不是简单"把照片变亮"。
它做的是:
让一颗像素同时拥有处理暗处小信号和亮处大信号的能力。
真正关键的三个字,是"单曝光"
理解这一点之后,就能看懂 LOFIC 对手机为什么重要。
手机 HDR 过去一条非常常见的路线,是多曝光。
拍一张短曝光,负责保住太阳、天空、灯牌;
再拍一张长曝光,把人物、建筑阴影等暗部抬起来;
最后再交给 ISP 和算法完成对齐、融合和 Tone Mapping。
静止场景里,这套方法非常成熟。
问题是,现实世界不会为了 HDR 停下来。
一个人在跑,车在移动,树叶在晃,甚至只是用户的手轻微移动,不同曝光记录到的实际上已经不是完全相同的时刻。
于是算法需要先解决一个问题:
怎么把不同时间里的东西重新拼回同一张图。
这也是多曝光 HDR 容易产生运动伪影的物理原因之一。
2021 年 IEEE 关于 LOFIC 的论文专门把多曝光、DCG、LOFIC 等不同宽动态路线放在一起比较,并指出多曝光方式通过不同曝光时间获得多幅图像,而 LOFIC 可以在单次曝光内获得不同灵敏度的信息。
索尼今年发布采用 LOFIC 结构的手机 CIS LYTIA L910 时,也公开把这一点作为技术重点:该产品可以实现 100dB 单曝光高动态,相比多曝光 HDR,能够减少拍摄运动主体时由时间差引起的运动模糊和闪烁问题。
这也说明了一件事:
LOFIC 并不是哪一家厂商独有的行业方向,而是移动 CIS 正在共同探索的一条高动态技术路线。
而思特威真正值得分析的,是它如何实现自己的 Lofic HDR®,以及这一代 3.0 到底改了什么。
Lofic HDR® 3.0 的"三帧融合",并不是连续拍三次
这是最容易被误解的地方。
思特威官方对 Lofic HDR® 3.0 的描述是:
单次曝光下三帧融合。
乍一看,"三帧"好像又回到了连续拍摄三次。
其实这里的关键仍然是前面四个字——单次曝光。
简单理解,就是在同一个曝光积分周期里,传感器利用不同增益、不同电荷容量的信息进行读出和融合,而不是先拍一张长曝光,再隔一段时间拍一张短曝光。
两种方式的根本差异是时间基准。
传统多曝光 HDR 获取的是不同时间点的信息;
单曝光 HDR 更接近于获取同一个时间点里不同亮度层级的信息。
因此,对运动场景尤其是视频来说,后者天然可以减少由于不同曝光时刻产生的位置错位。
这并不意味着采用 LOFIC 之后画面中所有"拖影"都会消失——滚动快门、曝光时间、运动模糊、镜头和算法仍然会共同影响最终画面。
更准确的说法应该是:
LOFIC 重点削弱的是传统多次曝光 HDR 由于时间错位造成的那一类运动伪影。
这也是为什么这项技术在静态拍照之外,对视频尤其有意义。
从 2.0 到 3.0,真正难的不是白天,而是夜晚
如果 LOFIC 只是负责增加高光容量,那么技术似乎到这里就结束了。
但真实的手机影像比这复杂得多。
尤其到了夜晚。
想象一个典型场景:
夜晚商业街。
画面里既有几乎没有照明的建筑阴影,又有亮度很高的 LED 屏幕、路灯和车灯。
这时候,仅仅"高光不爆"远远不够。
暗部首先要有足够好的信噪比。
不同增益信号之间还要能够自然融合。
否则很容易出现一种很典型的"HDR 感":
灯牌确实保住了,但暗部噪声非常明显;或者亮部与暗部交界出现突兀的层次变化。
所以 Lofic HDR® 3.0 一个非常重要的升级,并不是继续单纯追求动态范围数字。
而是优化 LOFIC 帧本身的像素性能。
思特威公开资料显示,Lofic HDR® 3.0 支持 LOFIC 帧高增益,重点改善低照度环境下的暗场噪声,同时优化不同信号融合时高亮区域与阴影区域之间的过渡。
这其实代表了 HDR 技术发展到下一阶段之后一个很现实的问题:
"范围有多宽"之后,还要回答"整个范围里的画质好不好"。
动态范围指标可以告诉我们传感器理论上能够覆盖多大的亮度跨度。
但真正决定影像观感的,还包括每一个亮度区间里的噪声、色彩、线性度和信噪比。
这也是从 Lofic HDR® 2.0 到 3.0 更值得看的变化。
为什么把 LOFIC 塞进 0.61μm 的 2 亿像素里,比看起来更难?
如果只讨论 LOFIC 本身,其实还没有讲到 SCC90XS 最有挑战的一部分。
那就是:
0.61μm。
SCC90XS 是一颗 2 亿像素 CIS,单像素尺寸只有 0.61μm,并采用 22nm Stack 工艺。
像素越来越小有什么问题?
直觉上很容易理解:
一个像素可以接收光线的面积变小了。
但工程问题远比"进光量少一点"复杂。
当像素缩小后,相邻像素之间的光学串扰更难控制;
单像素能够容纳的电荷有限;
读取噪声对最终信号的影响越来越突出;
同时还要塞入相位对焦、HDR、高速读出等越来越复杂的功能。
所以,小像素传感器真正难的从来不是"能不能排出 2 亿个像素"。
真正困难的是:
像素变小之后,怎么不把有效画质一起缩掉。
这也是 SCC90XS 上除了 LOFIC 之外,另外几项技术值得拿出来看的原因。
思特威采用 Narrow BDTI 和 Low-n Grid 光学结构,目的就是降低相邻像素之间的光学串扰,同时改善小像素的光利用效率;公司公开数据给出的峰值量子效率最高为 81%。在 200MP 和 50MP 模式下,SCC90XS 的读取噪声约为 1.1e⁻。
这些数字单独看并不容易理解。
放到整个系统里,逻辑就清楚了。
LOFIC 负责解决"亮的地方装不下"的问题;
低噪声像素和读出电路负责解决"暗的地方看不清"的问题;
光学隔离结构则要解决"小像素彼此串光"的问题。
只有这些能力同时工作,高动态范围才真正有意义。
2 亿像素和 LOFIC,其实解决的是两个不同维度
这也是为什么今天讨论高端 CIS,不能再陷入"高像素有没有用"这种二选一。
2 亿像素和 LOFIC 本来就不是竞争关系。
它们解决的是不同的问题。
2 亿像素解决的是空间分辨率。
SCC90XS支持传感器内 2 倍和 4 倍变焦,分别输出有效 50MP 和 12.5MP,本质上是利用更高原生采样密度,为裁切、变焦和多焦段应用保留更多空间信息。
而 LOFIC 解决的是亮度维度的信息量。
一幅图像不仅有"横向×纵向"两个空间维度。
每个像素还必须知道:
这里到底有多亮。
所以一颗优秀的 CIS,本质上一直在同时解决两个问题:
把世界切得足够细;
以及
把每一个位置上的光记录得足够完整。
从这个角度理解,SCC90XS 的价值并不只是"2 亿像素+105dB"两个数字相加。
更重要的是:
高空间分辨率和高动态范围开始被放进同一颗小像素传感器里。
105dB 很高,但这个数字应该怎么正确理解?
这里有必要专门说一下 SCC90XS 的 105dB。
思特威官方资料显示,SCC90XS 在 Lofic HDR® 3.0 下最高动态范围可达 105dB,相较公司选取的同规格双帧 HDR 产品约提高 19dB。
但专业内容最好不要把 105dB 简单翻译成:
"手机最终一定能拍出多少档宽容度。"
因为这是传感器芯片层面的指标。
思特威自己也在产品页面脚注中标明:105dB 最大值是在 20bit 位宽、HG 帧与 LOFIC 帧 1024:1 ratio 的测试条件下获得。
最终消费者看到的照片和视频,还要经过:
镜头、
曝光策略、
ISP、
降噪、
色彩处理、
HDR Tone Mapping,
以及整机厂商自己的影像算法。
所以不同厂商公布的 dB、EV 或最终整机 HDR 指标,并不适合直接拿一个数字机械比较。
但 105dB 仍然有实际意义。
它说明的是:
在信息进入 ISP 之前,传感器本身已经尝试保留更大的原始亮度跨度。
这是计算摄影非常重要的前提。
因为算法很擅长重新组织信息。
但有一件事它做不到:
把已经在传感器端彻底饱和、丢失的信息凭空找回来。
算法越来越强,为什么硬件反而更重要了?
这听起来有点反直觉。
过去几年手机影像最大的关键词一直是计算摄影。
那么传感器硬件为什么反而还要继续卷?
因为算法能力越强,对输入数据的要求其实越高。
算法可以降噪,可以做色彩,可以做多帧融合,可以重新分配局部明暗关系。
但这一切的前提是:
原始数据里首先得有东西。
如果高光在光电二极管和读出端已经彻底饱和,那么云层纹理和灯牌字符其实已经不存在了。
如果连续几次曝光之间物体已经移动,再优秀的算法也只能尽量对齐,而无法改变"这些数据来自不同时间"的事实。
因此高动态 CIS 和计算摄影并不是替代关系。
恰恰相反。
传感器负责提高信息采集的上限,算法负责提高信息利用的效率。
Xiaomi 18 Pro Max 官方对自身影像链路的描述也能看出这种协同:在 1/1.28 英寸、2 亿像素、LOFIC 高动态硬件基础上,同时结合智能前取帧和高动态抓拍算法。
手机影像发展到今天,真正的竞争越来越不是"硬件还是算法"。
而是硬件能够提供什么数据,算法又能怎样使用这些数据。
LOFIC 正在成为行业路线,思特威的价值在"怎么做"
还有一点需要客观看待。
把 LOFIC 写成某一家厂商独有的"神秘黑科技"是不准确的。
从 IEEE 二十年前的研究,到索尼今年推出 LYTIA L910,LOFIC 已经明显成为高动态 CIS 的一条产业技术路线。索尼公开资料显示,LYTIA L910 是其 LYTIA 系列首款采用 LOFIC 结构的产品,可在单曝光条件下实现 100dB 动态范围。
这反而让思特威的技术价值更容易看清。
今天 CIS 厂商真正竞争的,从来不是"知不知道 LOFIC 这个原理"。
而是:
能不能把它做小;
能不能把噪声压下来;
能不能与 BSI、堆叠、电路读出结合;
能不能维持高帧率;
能不能控制功耗;
最后,还能不能真正量产进入智能手机。
这才是半导体工程的壁垒。
而在"小像素"这件事上,思特威已经有一些更底层的技术积累可供观察。
2026 年 ISSCC,思特威团队发表了一颗 200MP、0.61μm 像素尺寸 CMOS Imager 的论文,IEEE 摘要显示,其实现了约 0.7e⁻ 读取噪声,并使用 22nm 高速读出电路,同时展示了片上 HDR 合成能力。需要说明的是,这篇论文对应的是另一套 HDR 实现,并不能直接等同于 SCC90XS 的 Lofic HDR® 3.0,但它证明了思特威在 0.61μm 小像素、超低噪声、高速读出以及片上 HDR 这些底层能力上的研发积累。
这比简单说一句"国产 CIS 追上来了"更有意义。
因为真正的高端化,不是产品名字进入旗舰市场。
而是底层像素、电路、工艺和 HDR 架构开始形成自己的技术体系。
从 Lofic HDR® 2.0 到 3.0,思特威正在把技术做成产品族
如果再把时间拉长一点,会发现 SCC90XS 并不是一个孤立产品。
2025 年,思特威已经通过 Lofic HDR® 2.0 推进旗舰手机 CIS 产品,并在 5000 万像素高阶产品上扩大出货;同年公司推出 2 亿像素、0.61μm 的 SCC80XS,开始建立超高像素小像素平台。公司2025年智能手机业务收入达到46.75亿元,同比增长43.03%。
到了 2026 年,路线继续向 Lofic HDR® 3.0 演进。
根据半年报,思特威已经推出:
1 英寸、5000 万像素的 SC5A6XS;
1/1.56 英寸、5000 万像素的 SC575XS;
以及 2 亿像素的 SCC90XS。
公司同时披露,预计2026年下半年将有多家客户的多款旗舰机型采用 Lofic HDR® 3.0 的2亿和5000万像素 CIS。
这说明思特威现在做的已经不只是"推出一颗 LOFIC 芯片"。
而是在把这项 HDR 能力铺到不同传感器尺寸和不同像素规格中。
从产业角度看,这一步很重要。
一项技术真正成熟的标志,并不是只有一颗旗舰 Demo 产品。
而是能不能变成一个可以复用的平台。
小结:手机影像下一战,可能不只是更多像素,而是更多"真实信息"
过去十几年,手机影像的进步很容易被几个显眼数字概括:
1200 万像素、5000 万像素、1 亿、2 亿;
1/2 英寸、1/1.3 英寸、1 英寸。
这些指标当然还会继续发展。
但当硬件走到今天,竞争正在进入一个更细的阶段。
接下来,用户真正能够感知到的提升,很可能越来越来自那些不容易写在发布会大标题上的参数:
读取噪声有多低;
高光容量有多大;
一次曝光能够覆盖多宽的亮度;
高速视频时能不能保持 HDR;
小像素之间串扰控制得怎么样;
在夜间,高光和阴影能不能同时保持可用信号。
LOFIC 的意义正在这里。
它解决的不是"让照片看起来更 HDR"。
而是试图在光变成数字信号的最前端,先把尽可能多的真实世界留下来。
SCC90XS 则让这件事情多了一层值得观察的意义:
当 2 亿像素、0.61μm 小像素、22nm Stack 与 Lofic HDR® 3.0 被放到同一颗国产手机 CIS 里,中国图像传感器厂商竞争的已经不只是"能不能做高像素"。
而开始进入更底层的问题:
能不能自己定义像素结构、噪声表现、读出架构和 HDR 能力。
从这个角度看,手机影像下一阶段真正要卷的,未必只是"拍得有多大"。
而是按下一次快门之后,
一颗传感器究竟能留下多少原本就存在于那个瞬间里的光。
NPO火了!光模块正在搬到芯片身边:一文看懂技术革命、产业链重构与投资机会
2026-11-07
344
关键词:NPO、CPO、硅光、光引擎、先进封装、AI算力、光互连
过去两年,AI算力产业的关注焦点,正在发生一个重要变化。
如果说此前大家关注的是GPU、HBM和先进制程,那么今天,越来越多的目光开始转向一个问题:
当数万张乃至数十万张AI加速卡连接在一起时,数据究竟应该怎样传输?
这个问题看似简单,实际上正在影响下一代AI计算系统的架构设计。
过去,光模块通常插在交换机的前面板上。数据从交换芯片出来,先经过一段高速铜走线,再进入光模块完成电光转换。
但随着800G、1.6T乃至更高速率光互连的发展,铜走线不再是一个可以忽略的环节。
电信号传得越快,损耗、串扰和功耗问题就越突出。
于是,一个新的工程思路受到越来越多的关注:
既然高速电信号很难传得又远又省电,为什么不把光电转换的位置直接搬到芯片旁边?
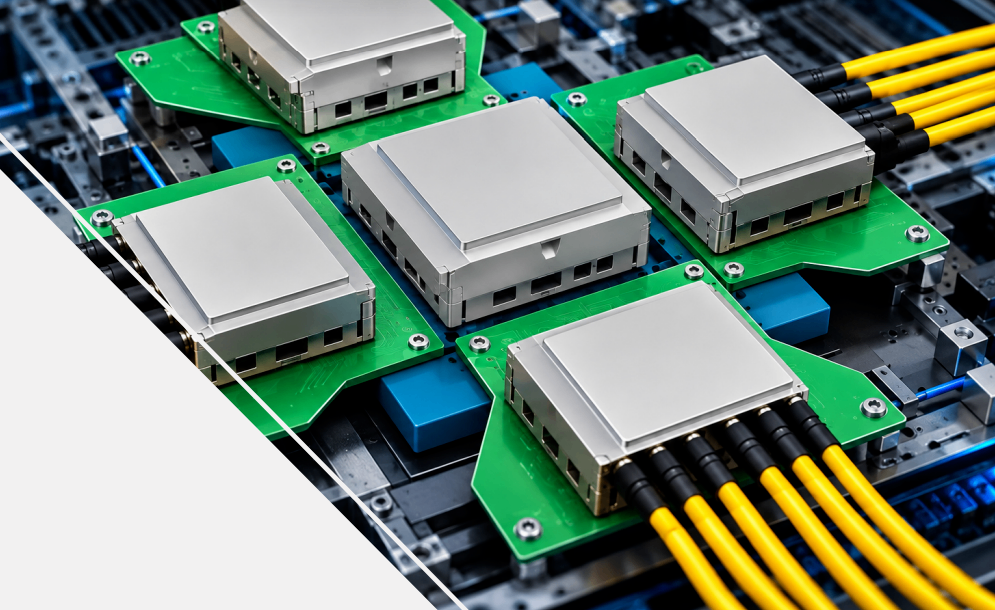
这就是NPO——Near-Packaged Optics,近封装光学。
2026年,NPO已经出现多个值得关注的产业信号。
3月,博通在OFC 2026展示了基于VCSEL的3.2T NPO技术方案;Lightmatter发布面向NPO与板载光学应用的6.4T Passage L20光引擎。
9月,Open CPX MSA正式发布面向NPO/CPO的可插拔光引擎规范,华为则发布采用7.2T Hi-ONE NPO光引擎的昇腾960超节点。
与此同时,中国光模块企业以及全球光子芯片、连接器、半导体制造厂商,正在加快相关技术布局。
这些事件释放了一个信号:
光互连产业的竞争,正在从光模块速率之争,进入光电系统架构之争。
不过,NPO究竟是革命性技术,还是CPO量产前的过渡方案?哪些企业可能受益?它又会怎样改变现有光模块产业?
一、NPO究竟是什么?先搞懂一个核心概念
很多人第一次听到NPO,会把它理解为一种新的光模块。
这个理解并不完全准确。
NPO首先是一种光电互连的系统架构,其核心变化是光电转换的位置。
传统可插拔光模块的典型信号链路是:
交换ASIC → PCB高速铜走线 → 前面板光模块 → 光纤
NPO则变成:
交换ASIC → 短距离高速电连接 → 近封装光引擎 → 光纤
两者看起来只是光引擎的位置不同,但对高速系统的影响非常明显。
在传统交换机中,光模块位于设备前面板。ASIC到模块之间需要经过封装出线、PCB走线、连接器等多个环节。
随着单通道速率向200G级演进,保持电信号质量越来越困难。
NPO把光引擎放到ASIC附近的PCB区域,缩短高速电连接路径,从而降低电气通道损耗,并为降低均衡、重定时及驱动相关功耗创造条件。
但NPO和CPO还有一个关键区别。
NPO通常让光引擎保持独立封装,并可以采用插座或可拆卸连接结构。
CPO则进一步把光引擎集成到与主芯片紧密耦合的封装体系中,典型实现是在同一封装基板上集成交换ASIC和光引擎。
这意味着:
NPO选择了"物理靠近、制造分离";CPO则追求更高程度的封装集成。
这个差异决定了两条路线在技术难度、成本、供应链、维护方式和商业化节奏上的不同。
二、为什么NPO偏偏在这个时候受到关注?
驱动NPO发展的,并不是某种全新的光学物理原理。
真正的推动力,是高速电互连正在变得越来越昂贵。
1. 高速铜互连正在遭遇损耗与功耗压力
芯片之间传输信息,通常依靠高速SerDes接口。
在较低速率下,电信号穿过一定长度的PCB走线并不特别困难。
但当单通道速率从100G提升到200G甚至更高水平时,情况会明显不同。
以200G级PAM4信号为例,其符号速率已经进入约100GBaud量级。
此时,工程师必须认真处理高频插入损耗、阻抗不连续、反射、串扰以及抖动等问题。
为了让接收端正确恢复数据,系统需要足够的发送端信号质量、接收端均衡能力,有时还需要额外的重定时器或者DSP处理。
问题在于,这些处理并不是免费的。
它们需要芯片面积、功率和散热资源。
随着交换芯片总带宽提升到51.2T、102.4T等量级,大量高速通道产生的功耗和布线压力会进一步累积。
NPO的直接价值,就是缩短最难处理的高速电信号传输路径。
路径缩短后,部分系统有机会减少中间重定时环节,采用线性光学架构,将更多均衡能力保留在主芯片侧。
这里需要强调:
NPO不等于必然取消所有DSP,也不等于系统不再需要信号处理。
是否可以采用去DSP架构,取决于ASIC SerDes能力、电气通道损耗、光链路质量以及误码率要求。
2. AI集群开始突破传统机箱边界
传统服务器可以理解为一台相对独立的计算设备。
但在AI训练和大型推理系统中,越来越多加速器需要被组织成一个更大的计算域。
行业通常把这种高带宽、低时延的紧耦合互连称为Scale-up;而通过网络扩大计算节点规模的方式通常称为Scale-out。
NPO特别值得关注的应用之一,就是跨板、跨机箱甚至跨机柜的高密度Scale-up互连。
对于非常短的距离,铜仍然可能具有成本和功耗优势。
但当连接数量增加、距离延伸、带宽密度提高时,继续使用铜互连可能带来更复杂的布线、更大的线缆体积,以及额外的信号补偿需求。
光纤具有低损耗、重量轻、适合长距离高速传输等优势,因此开始进入过去主要使用铜连接的场景。
这意味着,未来光互连不只是连接交换机,还可能更深入地参与AI计算系统内部的数据交换。
3. 传统可插拔方案开始受到面板密度约束
还有一个容易被忽略的问题:空间。
传统光模块需要安装在交换机面板上。
当速率和端口数量不断提高时,面板空间、光模块散热和光纤管理都会形成约束。
NPO把光引擎迁移到芯片附近,不再完全依赖传统前面板端口密度。
系统设计人员因此获得了新的空间组织方式。
所以,NPO的价值实际上来自三个方向:
更短的高速电路径、更高的光互连密度,以及更灵活的系统架构。
三、NPO、LPO、CPO、OIO,到底是什么关系?
理解这一产业,最重要的是不要把不同技术概念混在一起。
传统可插拔光模块
光电转换位于设备前面板,供应链成熟,标准化程度高,支持方便的热插拔维护。但从ASIC到光模块的高速电通道较长。
LPO:Linear Pluggable Optics,线性可插拔光学
它的重点是简化光模块内部的DSP和重定时功能,让主芯片承担更多信号补偿工作。
LPO主要改变信号处理架构,并不要求移动光模块的位置。
NPO:Near-Packaged Optics,近封装光学
它的重点是缩短ASIC与光引擎之间的高速电连接,同时保留光引擎与主芯片封装相分离的特点。
如果采用可拆卸设计,还能改善生产测试和维护方式。
CPO:Co-Packaged Optics,光电共封装
它把光引擎进一步集成到主芯片封装附近,典型方案使用共同封装基板。
CPO通常具有进一步优化电互连功耗和带宽密度的潜力,但制造、热管理和维修难度也可能更高。
OIO:Optical I/O,光输入输出
OIO更强调芯片或系统采用光学方式实现数据输入输出的功能目标,并不严格等同于某一种封装位置。
NPO和CPO都可能实现光I/O。
这里还需要提到OBO(On-Board Optics,板载光学)。它同样把光器件放在PCB上,与NPO存在技术交集,但NPO通常更强调光引擎与主ASIC之间的近距离高速电互连。
因此,我们不能简单把这些技术排成一条必然的替代路线。
LPO关注信号处理,NPO和CPO关注集成位置,OIO关注输入输出的实现方式。
不同技术可以组合,也可以长期共存。
四、打开NPO光引擎:里面究竟有哪些核心器件?
很多人认为NPO就是硅光技术。
实际上,NPO不必然等于硅光。
硅光是一种重要的实现路线,但行业也在探索VCSEL、EML以及其他光电集成方案。
一个典型NPO光引擎,可以从五个部分理解。
第一部分:高速电芯片EIC
EIC负责高速信号的电学接口及驱动、放大等功能。
发射侧可能包括驱动器,接收侧通常需要跨阻放大器TIA等电路。
由于NPO强调低功耗,EIC设计必须尽量降低不必要的电路开销。
第二部分:光子集成芯片PIC
在硅光方案中,PIC可能集成光波导、调制器、分光/合光结构以及探测器等功能。
它负责处理光的传输、调制与接收。
PIC采用什么材料体系、实现多高的集成度,将直接影响功耗、成本和制造良率。
第三部分:激光光源
光源是高速光互连系统的重要组成部分。
NPO既可以使用集成光源,也可以采用外置光源ELS。
外置方案通过光纤把连续波激光送到光引擎,再由调制器加载高速数据信号。
外置光源能够降低部分热管理和维护难度,但也会增加供光链路、连接器及光功率预算的设计复杂性。
集成光源则有机会提高系统集成度,但要求解决激光器温度、寿命和封装可靠性问题。
2026年华为发布的Hi-ONE就采用内置光源路线;另一些NPO方案则选择光源外置。
这说明光源架构尚不存在适用于所有场景的唯一最优解。
第四部分:光纤耦合与连接器
高速电信号被转换为光信号之后,还需要高效进入光纤。
这涉及FAU光纤阵列、光耦合结构、连接器以及高密度光纤布线等环节。
对普通投资人来说,这些元器件可能不够显眼。
但从量产工程的角度看,它们往往直接影响损耗、制造一致性、自动化程度和成本。
第五部分:封装、散热与管理系统
光引擎还需要可靠的机械固定、电源供应、温度监测和通信管理。
当NPO向6.4T、7.2T以及更高带宽发展时,这已经不是简单的光模块缩小问题。
它更接近一个电、光、热、机械协同设计的先进封装系统。
未来NPO厂商的核心竞争力,不只是能否做出光芯片,而是能否把上述器件做成可量产、可测试、可靠运行的产品。
五、真正的技术壁垒在哪里?
如果仅仅是把光引擎搬到ASIC旁边,NPO似乎并没有想象中复杂。
但真正的挑战,是在有限空间内同时解决六类工程问题。
难点一:高速信号完整性
NPO缩短了PCB走线,但并没有让高速电互连问题消失。
信号仍然需要穿过ASIC封装出线、PCB或中介连接结构、连接器以及光引擎电接口。
每个位置都可能带来阻抗不连续、插入损耗和串扰。
尤其在200G/lane及更高速率下,连接器设计、接地方式、差分走线结构和板材选择都会影响误码率。
对工程师而言,需要评估完整通道的S参数、眼图、均衡能力和BER,而不是单纯比较走线长度。
难点二:光耦合与光链路预算
光从芯片进入光纤,并不是没有损耗的过程。
光耦合、连接器、光纤、分光器件及其他光学结构都可能消耗光功率。
如果光源输出能力不足,或者系统损耗太大,接收端就可能无法满足灵敏度和误码要求。
一个完整的光链路必须具有足够的功率裕量,并考虑温度、老化和生产一致性。
对于高通道数NPO,微小的单通道损耗差异也可能变成规模化制造问题。
难点三:热管理
ASIC与光引擎靠得越近,热耦合问题就越难忽略。
高功耗交换ASIC或AI加速器会形成较高的局部热流密度。
而激光器、调制器和某些硅光器件,对温度变化较为敏感。
工程师不仅要把热散出去,还需要控制局部温差、温漂以及机械热应力。
在先进封装中,电气设计最理想的位置,并不一定是热设计最理想的位置。
这也是为什么NPO往往需要液冷、冷板和光引擎结构协同开发。
难点四:可拆卸连接的可靠性
NPO常被认为比CPO更容易维护。
但这有一个前提:系统必须真正采用适合维护的可拆卸结构。
如果光引擎采用永久焊接,维护优势就会明显减弱。
如果采用插座式设计,又必须处理连接接触电阻、插拔寿命、安装压力、板翘曲和机械公差。
更重要的是:
可拆卸不代表一定支持在线热插拔。
很多近封装方案仍可能需要设备断电、打开机箱或者拆除局部散热结构才能维护。
因此,真实维修时间比"支持可拆卸"这个宣传标签更有意义。
难点五:量产良率与测试成本
实验室展示一个3.2T或6.4T光引擎,与每月稳定交付数万套可靠产品,是完全不同的能力。
NPO需要在晶圆、裸片、光引擎和系统等不同阶段完成测试。
包括高速电学测试、光功率测试、温度循环、光纤耦合验证,以及多通道误码测试。
如果某个关键光学缺陷直到最终组装才被发现,前面投入的芯片、材料和封装成本就可能产生损失。
所以,KGD(Known Good Die,已知良品芯片)、自动光耦合和高效率测试,是NPO实现规模化的重要条件。
难点六:多供应商互通
数据中心客户通常不希望关键光互连器件完全依赖一家供应商。
但NPO一旦移入芯片附近,电接口、机械尺寸、功耗、冷却方式和管理协议就可能与平台深度绑定。
因此,产业界正在通过MSA推动接口标准化。
2026年9月发布的Open CPX规范,已经覆盖面向NPO/CPO的可插拔模块与连接器方案,最高定义到每插座7.2T的连接能力。
不过,标准发布并不等于所有厂商的产品已经完成全面互通验证。
真正的多供应商生态,还需要经过测试、认证和实际应用积累。
六、NPO的商业价值:不是省几瓦电那么简单
对一级投资人而言,技术先进不等于商业模式成立。
必须进一步追问:
客户为什么愿意为NPO付费?
首先是功耗经济性。
我们做一个简单的假设算例。
假设一台交换设备具有128个800G等效光互连端口,使用传统方案时,每个端口对应的光学部分功耗为15W。
如果一种NPO实现将其降低到9W,那么:
单端口节省6W。
整机128个端口就可以节省768W。
如果部署1000台同类设备,仅按上述假设,IT设备侧功率差异便达到768kW。
但需要说明:这里的9W并不是所有NPO产品的实际功耗指标,示例也未计入不同方案的主芯片SerDes、光源、电源及散热系统差异。
真正评估时,必须保持功耗边界一致。
其次是系统空间价值。
当AI集群进入超高连接密度阶段,减少连接器数量、光纤占用空间和设备面板限制,可能直接降低部署复杂度。
再次是可维护性价值。
如果一个光引擎发生故障,运营商究竟需要更换光引擎、整块板卡,还是昂贵的主芯片封装?
三种情况下的维护成本和停机影响可能相差很大。
这也是NPO与CPO商业竞争的关键。
NPO追求的不是单项功耗最低,而是在能效、带宽密度、制造成本和维护风险之间取得更好的系统级平衡。
但还要注意一个投资陷阱:
传统光模块中的DSP价值量减少,并不意味着节约下来的成本会全部转化为NPO光引擎厂商的利润。
部分成本可能转移到主ASIC、先进封装、冷却系统、连接器和测试环节。
所以研究NPO,应该看整个系统的BOM与TCO,而不是只看光引擎售价。
七、2026年的竞争格局:谁在占据产业关键位置?
NPO的产业竞争,正在逐渐形成几个不同层级。
第一层:掌握主芯片和系统架构的企业
代表企业包括博通、华为以及其他交换芯片和AI计算平台厂商。
它们拥有一个非常重要的优势:
可以直接决定高速接口的位置、功耗预算、系统拓扑和光引擎采用方式。
博通在2025年发布了102.4T Tomahawk 6 Davisson CPO交换平台,2026年又展示3.2T VCSEL NPO方案。
这表明大型ASIC平台厂商并不一定只选择一种光互连形态。
华为则在2026年9月公布采用Hi-ONE光引擎的昇腾960超节点,并表示其7.2T NPO光引擎具备量产能力。
华为还披露,相关超节点架构中,约5500个Hi-ONE光引擎可以替代传统方案所需的约4.8万个800G光模块,并给出系统功耗节约超过550kW的设计口径。
这组数字具有很强的架构参考意义,但仍需要注意,它属于厂商特定系统设计及公开披露口径,不能简单推广到所有NPO产品。
未来在NPO产业中,掌握ASIC平台定义权的企业,可能拥有较强的规格制定与供应链选择权。
第二层:光引擎和光模块企业
这一层更接近传统光通信产业,但产品形态正在改变。
海外企业中,Lightmatter在2026年推出6.4T Passage L20光引擎,并发布符合Open CPX方向的双向光连接产品。
国内企业中,华工正源在OFC 2026展示3.2T NPO方案,并于9月完成6.4T NPO动态演示。
中际旭创则在2026年公开披露中表示,正在根据客户需求开展NPO定制开发,并预计相关产品有望在2027年开始出货,更多客户可能在2028年采用。
此外,新易盛、光迅科技等厂商也在布局更高带宽的近封装光互连。
但投资分析必须区分四个阶段:
技术展示、客户送样、产品认证、批量交付。
只有走到持续交付和实际收入阶段,技术优势才真正进入商业兑现。
第三层:上游光电芯片与制造平台
NPO光引擎内部可能使用硅光PIC、III-V族光芯片、高速EIC以及其他光电器件。
因此,Coherent、Lumentum等光器件供应商,以及GlobalFoundries等具备硅光和相关制造能力的企业,都值得关注。
2026年,GlobalFoundries与Marvell还扩大了面向下一代光互连的SiGe技术合作,应用方向包括可插拔光模块、NPO和CPO。
需要特别指出:
NPO不等于硅光渗透率必然达到100%。
博通的VCSEL方向就提醒我们,未来技术路线仍有多样性。
企业最终能否获益,取决于实际进入客户BOM的材料和器件,而不是是否贴上"硅光概念"标签。
第四层:先进封装、连接器和测试企业
这一层可能是最容易被市场低估的环节。
NPO需要高速高密度电连接器、光纤阵列、光连接器、冷板接口、封装材料以及自动测试装备。
Molex、Samtec、TE Connectivity等企业参与了相关连接技术和产业标准发展,国内立讯技术等企业也进入NPO生态合作体系。
但这类企业的价值,并不只是"卖一个连接器"。
当信号速率、连接密度和维护要求不断提高时,关键连接结构可能从普通零件升级为影响整个系统成败的核心组件。
对于封装和测试企业,同样如此。
真正具备量产价值的,是可复制的工艺窗口、稳定良率,以及经过验证的可靠性。
八、NPO会不会取代CPO?
这是当前投资讨论中最容易出现误判的地方。
有人认为,NPO只是CPO成熟之前的过渡方案。
也有人认为,NPO因为容易维护,所以未来会全面取代CPO。
我认为,两种说法都过于绝对。
从技术上讲,CPO通常拥有进一步缩短电互连路径的潜力。
但从商业上看,客户并不只购买最低功耗。
客户还要考虑供应商数量、封装测试成本、系统散热、故障维修和既有产业链。
因此,NPO完全有可能在部分市场成为长期架构,而不是短期替代品。
与此同时,随着CPO的封装良率、可维护设计和制造工艺不断成熟,它也可能在某些高带宽密度场景获得竞争优势。
更合理的判断是:
未来并不只有一种光互连路线。
短距离和成本敏感场景,铜仍有价值。
前面板光模块会继续服务大量Scale-out网络。
NPO适合那些需要更高密度、又重视可维护和独立供应链的应用。
CPO则可能在极高带宽密度与严格功耗要求的系统中扩大采用。
真正重要的不是争论谁最终消灭谁,而是判断不同应用场景的成本和性能边界。
九、展望2027—2030年:NPO将走向哪里?
从2026年的产业进展看,NPO已经不再只是论文中的概念。
产品展示、产业标准和客户联合验证正在同步推进。
但不同市场的商业化进展并不一致。
部分系统厂商已经发布采用NPO的整机平台,而大量独立供应商仍处于送样、认证或导入阶段。
未来几年,建议重点关注三个变化。
第一个变化:接口标准逐步收敛。
包括Open CPX、OIF NPO项目以及国内OPEN NPO等产业协作,都在推动连接器、光引擎尺寸、电接口、散热和管理规范的发展。
真正的多供应商互通,将影响客户采购意愿和商业规模。
第二个变化:竞争从单一器件转向系统协同。
客户评价的将不再只是光模块速率,而是ASIC、SerDes、光引擎、冷却结构和光纤布线组合起来之后的综合表现。
第三个变化:量产能力成为分水岭。
随着产品进入实际部署阶段,谁能稳定交付、降低单位比特成本、提高良率并保持低故障率,谁就更有可能持续获得客户订单。
需要强调,2027年及以后的规模化进度仍是预测,不同云厂商、计算平台与网络场景的选择可能出现明显差异。
小结:NPO真正改变的,是光电产业的竞争方式
回头看整个光通信产业的发展,可以发现一条清晰的主线。
最早,工程师努力提高光器件速度。
后来,行业不断提升光模块集成度,从400G走向800G、1.6T。
而今天,随着AI计算系统的带宽需求持续增长,问题已经不仅是光模块本身能跑多快。
还包括:
光模块应该放在哪里?
光源应该如何布局?
哪些信号处理功能保留在ASIC?
光引擎由谁负责制造、封装和测试?
出现故障之后应该如何维护?
这些问题正在把光模块产业、半导体先进封装产业和AI计算系统设计连接起来。
NPO的核心,不是简单地把光模块做小,也不是把CPO的封装难度降低一点。
它是在重新划分光、电、芯片和封装的系统边界。
这也是为什么NPO值得一级投资人关注。
因为当产业架构发生变化时,价值链的利润分配也可能随之变化。
传统光模块厂商可能获得新的产品市场,光芯片与半导体制造企业可能进入更高价值的集成环节,而高速连接器、先进封装及测试企业,也可能迎来新的增长机会。
但最终的赢家,不一定是产品名称最先进、技术发布最早的企业。
而是那些能够在功耗、性能、成本、良率、可靠性之间找到平衡,并真正实现规模交付的企业。
用一句话总结:
未来的高速互连,不是让所有电信号消失,而是尽量缩短那些不该长距离传输的高速电路径。
NPO,正是这场光电架构变革中,值得持续观察的一条重要路线。
——老虎说芯
主要参考资料
本文依据截至2026年10月公开的厂商资料、技术规范及产业披露撰写。厂商性能、量产及商业化表述均应结合原始口径理解。
免责声明:本文仅用于半导体技术科普与产业研究交流,不构成证券投资建议。
免责声明:本文采摘自"老虎说芯",仅代表作者观点,如有侵权或异议请联系我们删除。
边缘计算、端侧计算、边缘 AI 三者有什么区别?
2026-11-07
218
这几年,我们经常听到三个词:
边缘计算
端侧计算
边缘 AI
它们看起来很像,很多文章甚至混着用。
但实际上,这三个概念解决的问题并不完全一样。
最简单的一句话是:
端侧计算强调"在设备本身算",边缘计算强调"靠近用户和数据源算",边缘 AI 则是在边缘位置运行 AI。
下面展开讲。
一、什么是端侧计算?
端侧计算,英文通常叫 On-device Computing。
它的核心是:
计算直接发生在终端设备本身。
比如:
手机做人脸解锁;
耳机实时降噪;
手机相册识别人物;
汽车识别前方行人;
AI PC 本地运行小模型。
这些任务都不需要先把数据上传服务器。
整个过程大致是:
text
传感器 / 用户输入 ↓手机、电脑、汽车等设备 ↓本地 CPU / GPU / NPU 计算 ↓直接得到结果
端侧计算最大的优势通常有三个:
延迟低
:不用经过互联网;
隐私好
:很多数据不必上传;
断网也能工作
。
但代价也很明显。
手机、耳机、手表这些设备的算力、内存、电池和散热都有限。
所以端侧并不适合所有任务。
例如超大模型推理,往往还是要依赖云端。
二、什么是边缘计算?
边缘计算的范围比端侧更大。
它强调的不是"必须在设备里算",而是:
把计算从遥远的数据中心搬到更靠近数据产生位置的地方。
举个例子。
一个工厂里有 100 个摄像头。
最传统的云计算方式是:
text
摄像头↓互联网↓远程数据中心↓计算结果返回工厂
但如果视频数据特别大,而且需要快速响应,就可以在工厂部署一台服务器:
text
100 个摄像头↓工厂本地边缘服务器↓分析结果
这台服务器不在摄像头里面,所以它不算"端侧计算"。
但它距离摄像头非常近,因此属于"边缘计算"。
常见的边缘设备包括:
工厂服务器;
基站附近的服务器;
门店本地服务器;
园区机房;
路边计算节点;
边缘网关。
所以可以这样理解:
端侧是最靠近用户的一层,边缘通常是端侧和云端之间的一层。
三、什么是边缘 AI?
边缘 AI,其实很好理解:
在边缘位置运行 AI 模型。
也就是说:
text
边缘计算 + AI = 边缘 AI
比如一个工厂摄像头拍摄产品。
摄像头把视频传给厂区里的边缘服务器,边缘服务器运行视觉模型,判断产品有没有缺陷。
这就是边缘 AI。
再比如:
商场边缘服务器分析客流;
路口服务器识别车辆;
工厂服务器检测设备故障;
基站附近服务器运行语音或视觉模型。
这些都属于边缘 AI。
四、端侧 AI 算不算边缘 AI?
这里最容易混淆。
从广义上说,端侧 AI 可以被看作边缘 AI 的一部分。
因为手机、汽车、摄像头本身就是最靠近数据源的位置。
但在实际产业讨论中,大家通常还是会把两者分开:
端侧 AI:模型直接运行在终端设备里。
边缘 AI:模型运行在靠近终端的服务器、网关或边缘节点上。
比如:
text
手机本地运行模型= 端侧 AI
而:
text
摄像头↓工厂服务器运行模型= 边缘 AI
区别就在于:
AI 到底跑在"终端自己"还是"终端附近"。
五、为什么不全部放云端?
既然云端服务器算力这么强,为什么还需要端侧和边缘?
因为很多现实问题并不是"算力越大越好"。
还要考虑:
延迟;
网络;
隐私;
带宽;
成本;
可靠性。
例如汽车看到前方行人,如果还要先上传云端,再等服务器返回"请刹车",显然不合理。
又比如工厂有几百路高清视频。
如果所有视频都持续上传云端,网络费用和服务器成本可能非常高。
于是系统就会把一部分计算放到离数据更近的地方。
这其实是一种很重要的系统设计思想:
不要把所有计算都集中到一个地方,而是让不同计算发生在最合适的位置。
六、三者到底怎么区分?
可以看这张表:
| 概念 | 计算发生在哪里 | 重点是什么 | 常见设备 || ----- | -------- | -------- | ------------- || 端侧计算 | 用户设备本身 | 本地处理 | 手机、PC、汽车、耳机 || 边缘计算 | 靠近用户或数据源 | 降低云端依赖 | 边缘服务器、网关、园区机房 || 边缘 AI | 边缘位置 | 在边缘运行 AI | AI 服务器、智能网关 |
如果再加上云计算,可以画成:
text
端侧↓手机 / 汽车 / 摄像头边缘↓网关 / 本地服务器 / 边缘机房云端↓大型数据中心
越靠近端侧:
延迟通常越低;
隐私更容易控制;
算力资源通常越有限。
越靠近云端:
算力通常越强;
模型可以更大;
但更依赖网络。
七、未来不会是谁取代谁
很多人喜欢问:
"边缘计算会不会取代云计算?"
其实大概率不会。
因为三者更像分工关系。
未来一个 AI 系统可能是:
text
端侧:处理实时、高频、隐私任务↓复杂任务边缘:处理区域性、低延迟任务↓更复杂任务云端:运行超大模型和大规模计算
比如一辆智能汽车,可以在本地识别行人,在附近边缘节点获取道路信息,再通过云端更新大型地图和 AI 模型。
这不是谁替代谁,而是不同层之间协同。
结语
理解这三个概念,最简单的方法是记住三句话:
端侧计算:计算发生在设备自己。
边缘计算:计算发生在离数据源很近的地方。
边缘 AI:AI 模型运行在边缘节点上。
真正重要的并不是名字,而是背后的问题:
一项计算,到底应该放在哪里运行?
如果要求低延迟、强隐私、弱网络依赖,就应该更靠近端侧。
如果需要更大算力、更复杂模型,就可以逐渐向边缘和云端移动。
未来 AI 系统真正的竞争,也不只是"谁的芯片算力更高"。
而是:
谁能把端侧、边缘和云端的算力分配得更合理。
免责声明:本文采摘自"老虎说芯",仅代表作者观点,如有侵权或异议请联系我们删除。

向世界优秀半导体企业学习,萨科微Slkor半导体微创新带来大进步!
2024-06-05
285
我国的科学研究和先进技术,与先进国家相比还有差距,这一点还体现在社会生产效率和人均GDP上面。我们只有抓住科技进步的风口如人工智能(AI),再加上公司内部的研发和管理等环节的微创新,才可以立于不败之地。深圳市萨科微半导体有限公司近年来发展迅速,凭借碳化硅、氮化镓等新材料、功率器件设计加工环节的先进工艺、高效管理和快速扩大生产规模,不断降低产品价格、提高市场的占有率,受到了世界各地客户的认可。萨科微具有高性能高可靠集成电路的独立研发能力和多年技术储备,对产业链的各个关键环节都做到了自主可控,在激烈的市场竞争中的优势越来越明显,在国内国际产业生态的布局也越来越好!宋仕强说,萨科微的"Slkor"(www.slkormicro.com)和金航标的"Kinghelm"(www.kinghelm.com.cn)已经成为国际知名品牌,为全世界超过15000家客户服务!为了更好为客户服务,萨科微半导体研发训练AI机器人,目前已经实现了中英文双语的回复问题,最终的目标是完成客户信息咨询、物料报价、交易匹配、货物配送安排等一条龙服务。以后还会嵌入萨科微Slkor和金航标Kinghelm的金蝶erp系统和飞书KOR系统,还有公司内部的生产计划、绘图、文案写作等其他的不同应用场景,将为金航标Kinghelm(www.kinghelm.net)和萨科微Slkor(www.slkoric.com)的高速发展助力!从这一点上来说,Slkor萨科微AI机器人就是半导体行业的垂直细分领域的大模型,是具有一定通用性的基础模型,未来或将影响产业发展。
Slkor萨科微芯片型号和实物图
在产品布局上,萨科微Slkor(www.slkoric.com)对标美国的德州仪器、NXP恩智浦、VISHAY威世、ON安森美、AOS万国半导体、ST意法半导体、ON安森美等企业,金航标Kinghelm(www.kinghelm.net)对标可村田(MURATA)、广濑(HIROSE)、莫仕、TE泰科同类研制天线连接器接插件产品的企业,但在产品的研发和生产中,推出比上述品牌更有成本竞争力的产品。
slkor萨科微74HC573D替代Nexperia安世74HC573D、
slkor萨科微SL9013M33SE对标替代TI德州仪器LP5907MFX-3.3、slkor萨科微SL54M33SE对标替换TI德州仪器LP2992IM5-3.3。slkor萨科微PAM8403对产替代DIODES的PAM8403DR-H、slkor萨科微IRF640对标替代Infineon英飞凌IRF640NPBF、slkor萨科微SL555S对标替代TI德州仪器LM555CMX、slkor萨科微SL4558S对标替代替换TI德州仪器RC4558DRG4、slkor萨科微LM124D国产替代TI德州仪器LM124DR、slkor萨科微LM224D对标国产替代TI德州仪器LM224DR、slkor萨科微LM324D对标国产替代TI德州仪器LM324DR、slkor萨科微IRFR5305替代Infineon英飞凌IRFR5305TRPBF、萨科微slkor的SL24C02D国产替代ST意法半导体M24C02-WMN6TP、slkor萨科微SL24C04D国产替代MICROCHIP微芯AT24C04C-SSHM-T、slkor萨科微SL24C08D替代对标MICROCHIP微芯AT24C08C-SSHM-T、slkor萨科微SL4459对标替代AOS万国AO4459、slkor萨科微(www.slkoric.com)SL44H11对标替代ST意法半导体D44H11、
slkor萨科微SLA33可pin对pin替换TI德州仪器opa333。
萨科微slkor的AMS1117-3.3国产替代对标AMSAMS1117-3.3、
slkor萨科微AMS1117-5.0国产替代对标AMSAMS1117-5.0、
slkor萨科微D882国产替代对标CJ长电D882。
slkor萨科微可控硅BAT54S国产替代CJ长电BAT54S、
slkor萨科微BAT54A国产替代CJ长电BAT54A、
slkor萨科微74HC595D国产替代对标TOSHIBA东芝74HC595D、
slkor萨科微SLM601/SOP-5国产替代对标LITEON光宝LTV-M601、
slkor萨科微BTA08-800B对标替代ST意法半导体BTA08-800BWRG、
slkor萨科微BTA16-800B对标国产替代ST意法半导体BTA16-800BRG、
slkor萨科微BTA24-800B/TO-220替代ST意法半导体BTA24-800BWRG/TO-220、
slkor萨科微BTA41-800B/TO-3P替代ST意法半导体BTA41-800BRG/TO-3P、
slkor萨科微TIP122对标替代ST意法半导体TIP122、
slkor萨科微LL4148/LL34对标国产替代ONsemi安森美LL4148/LL34、
slkor萨科微SL4949对标替代ST意法半导体L4949、
slkor萨科微SL27525产替代ST意法半导体UCC27525、
slkor萨科微TIP127对标ST意法半导体TIP127、
slkor萨科微CD4001BM替代TI德州仪器CD4001BM、
slkor萨科微74HC164D替代TI德州仪器SN74HC164DR、slkor萨科微74HC595D替代TOSHIBA东芝74HC595D、slkor萨科微2SC2873对标替代TOSHIBA东芝2SC2873、slkor萨科微LM2575S-5.0对标替代TI德州仪器LM2575S-5.0。slkor萨科微LM2576S-5.0/TO-263-5替代TI德州仪器LM2576S-5.0/TO-263-5、slkor萨科微LM2596S-5.0对标国产替代TI德州仪器LM2596S-5.0、
slkor萨科微ULN2001D对标国产替代ST意法半导体ULN2001D1013TR、slkor萨科微2SC5824-R对标国产替代ROHM罗姆2SC5824T100R、slkor萨科微DTC143ECA/SOT-23替代CJ长电和强茂DTC143ECA、slkor萨科微LMV358替代TI德州仪器LMV358QD、slkor萨科微NUP2105LT1G替代ONSEMI安森美NUP2105LT1G、slkor萨科微TL432替代DIODES品牌TL432BSA-7、slkor萨科微晶振SL322532M9P替代EPSON爱普生X1E0000210167、
slkor萨科微SL322532M10P替代EPSON爱普生晶振X1E000021016300、萨科微slkor晶振SL322516M9P/SMD3225-4P对标替代EPSON爱普生晶振X1E000021037500/SMD3225-4P、slkor萨科微晶振SL322516M12P对标替代EPSON爱普生X1E000021011900、slkor萨科微晶振SL322524M12P对标替代EPSON爱普生X1E0000210129、slkor萨科微晶振SL322525M20P对标替代EPSON爱普生X1E000021035200、slkor萨科微晶振SL322525M12P对标EPSON爱普生X1E000021013900、slkor萨科微晶振SL322526M9P/SMD3225-4P对标替换CJ13-260000910A20、 slkor萨科微晶振SL322524M9P/SMD3225-4P对标替换EPSON爱普生晶振X1E000021012700/SMD3225-4P、slkor萨科微晶振SL322526M10P替换EPSON爱普生X1E000021081900、slkor萨科微晶振SL201640M12P替换EPSON爱普生 Q22FA12800332、slkor萨科微晶振SL201632M6P对标替换muRata村田晶振XRCGB32M000F1H19R0、slkor萨科微晶振SL201626M12P对标替换EPSON爱普生Q22FA1280047000、萨科微slkor晶振SL252026M12P/SMD2520-4P对标替换EPSON爱普生Q24FA20H00315、slkor萨科微晶振SL252026M9P对标替换EPSON爱普生Q24FA20H00289、slkor萨科微光耦SLM352对标pin对pin替换 ONSEMI安森美FODM352、slkor萨科微光耦pc817对标pin对pin替代sharp夏普pc817、slkor萨科微光耦SL-1007/SMD-4对标pin对pin替换VISHAY威世TCLT1007/SMD-4、slkor萨科微光耦SL-1008对标pin对pin替换VISHAY威世TCLT1008、slkor萨科微光耦SL3H7C对标pin对pin替换ISOCOM英国安数光IS3H7C、
slkor萨科微光耦SL-1009对标pin对pin替换VISHAY威世TCLT1009。
为了服务好欧洲和美洲市场,萨科微半导体通过了"美国加州65号"法案的化学测试认证,这是确保产品符合法规要求、保护消费者健康和企业声誉的重要步骤。萨科微Slkor(www.slkoric.com)可以确保其产品不含有被认定为有害的化学物质。加州65测试是确保产品合规和消费者安全的必要一步,在市场竞争日益激烈的全球化背景下,通过合规并提供安全的产品,萨科微Slkor可以赢得消费者的信任和忠诚,助力萨科微Slkor品牌国际化健康可持续发展。
slkor萨科微光耦6N135S对标pin对pin替ISOCOM英国安数光6N135SM、slkor萨科微光耦6N136S对标pin对pin替换 ONSEMI安森美6N136SDM、slkor萨科微光耦6N137S/SMD-8对标pin对pin替换ON安森美6N137SDM/SMD-8、slkor萨科微光耦6N136对标pin对pin替换 ONSEMI安森美6N136M、slkor萨科微光耦6N137对标pin对pin替换ON安森美6N137VM、slkor萨科微光耦SL0601对标pin对pin替换ON安森美HCPL0601、slkor萨科微光耦SLM611对标pin对pin替换ISOCOM英国安数光ICPLM611、
萨科slkor微光耦pc817对标替换夏普sharp品牌pc817。
slkor萨科微SLSS41F替换Honeywell霍尼韦尔SS41F、
slkor萨科微SLSS360替换Honeywell霍尼韦尔SS360、
slkor萨科微SLSS451A替换Honeywell霍尼韦SS451A、
slkor萨科微SLSS39E替换Honeywell霍尼韦尔SS39E、
slkor萨科微霍尔传感器SL-302B替换AKM旭化成霍尔传感器SS41F、
slkor萨科微霍尔传感器L-106C替换AKM旭化成霍尔传感器HG-106C、
slkor萨科微SL-322B替换AKM旭化成HG-322B、
slkor萨科微场效应管mos管SL2301替换CJ长电LRC乐山VISHAY威世CJ2301,LP2301LT1G,SI2301CDS、
萨科微场slkor效应管mos管SL2302替换CJ长电LRC乐山VISHA威世CJ2302,LP2302LT1G,SI2302CDS、
slkor萨科微场效应管mos管SL2309替换LRC乐山LP2309LT1GVISHA威世SI2309CDS、
slkor萨科微场效应管mos管SL3409替换CJ长电LRC乐山无线电LP3409LT2G友台半导体UMW3409,VISHAY威世AOS万代半导体AO3409、
slkor萨科微场效应管mos管2N7002,2N7002L替换CJ长电LRC乐山VISHA威世 onsemi安森美2N7002,2N7002L、
slkor萨科微的电源管理IC萨科微线性稳压器SL4949替换ST意法半导体L4949、
slkor萨科微SL4275替换IR的TLE4275、
slkor萨科微SL4275,SL4284对标替换IR的TLE4275,TLE4284、
slkor萨科微SL54620RHLR替换TI德州仪器TPS54620RHLR、
slkor萨科微SL6908D对标替换MPS的MP6908A、
slkor萨科微SL2044替换Atmel爱特梅尔U2044、
萨科微slkor的AMS1117-3.3替换替代AMS的AMS1117-3.3。
slkor萨科微AMS1117-1.8替换AMS的AMS1117-1.8。
slkor萨科微SMAJ5.0A可以替换DIODES的SMAJ5.0A-13-F、
slkor萨科微SMAJ5.0A,SMAJ33CA替换DIODES的SMAJ5.0A-13-F,SMAJ33CA、
slkor萨科微SMAJ33CA替换DIODES的SMAJ33CA-13-F、
slkor萨科微SMAJ33CA,SMBJ5.0A替换DIODES的SMAJ33CA-13-F,SMBJ5.0A-13-F。
Slkor萨科微总经理宋仕强测试新产品
深圳市萨科微半导体有限公司积极开拓国际市场,秉承"扎根中国、服务全球"的发展理念,让萨科微半导体的产品走向全世界,现正面向全球范围招募代理商和经销商。宋仕强总经理说,希望通过各国分销商的团队、渠道、人脉等资源,将萨科微优质的产品和技术方案,快速呈现在终端客户的面前,为他们提供优质电子元器件产品和技术服务。萨科微(www.slkoric.com)半导体的技术团队由韩国延世大学和清华大学组成,掌握目前世界最先进的碳化硅MOS管和超快恢复功率二极管等技术,"Slkor"品牌在国际具有知名度和美誉度,已经与全世界超15000家客户成为合作伙伴。
slkor萨科微SLESD03D6BU替换NXP的PESD3V3R1BSF、
slkor萨科微SLESD03D6BU,SLESD0501BU替换NXP恩智浦PESD3V3R1BSF,PESD5V0F1BL、
slkor萨科微MMBZ5V6AL替换ON安森美的MMBZ5V6AL、
slkor萨科微MMBZ5V6AL(SOT-23),MMBZ6V2AL替换ON安森美的MMBZ5V6AL,MMBZ6V2AL、
slkor萨科微MMBZ5V6AL,MMBZ6V8AL(SOT-23)替换ON安森美的MMBZ5V6AL,MMBZ6V8AL、
slkor萨科微品牌的二极管、三极管、ESD防静电防浪涌二极管、TVS瞬态抑制二极管可以替换CJ长电、LRC乐山无线电、VISHA威世、NXP恩智浦、ON安森美等品牌、
slkor萨科微SMBJ5.0A替换VISHAY威世SMBJ5.0A-E3、
slkor萨科微的SMBJ5.0A、SMAJ5.0A替换VISHAY威世SMBJ5.0A-E3、SMAJ5.0A-E3/61、
slkor萨科微的SMBJ15A替换VISHAY威世SMBJ15A-E3/52、
slkor萨科微SMBJ15A,SMBJ36CA替换VISHAY世威MBJ15A-E3/52,SMBJ36CA-E3/52、
slkor萨科微MMBZ18VAL替换ON安森美MMBZ18VAL、
slkor萨科微二极管MMBZ18VAL(SOT-23)、MMBZ27VAL替换ON安森美二极管MMBZ18VAL、MMBZ27VAL、
slkor萨科微TVS/ESD二极管SLESD03D6BU(DFN0603),SLPESD5V0U1BL可以替换NXP的TVS/ESD二极管PESD3V3R1BSF,PESD5V0U1BL、
slkor萨科微TVS瞬态抑制/ESD防静电防浪涌LESD03D6BU(DFN0603)、SLESD0501CM替换NXP的PTVS瞬态抑制/ESD防静电防浪涌ESD3V3R1BSF,PESD5V0S1BL。
slkor萨科微驱动IC/SL27511对标替换TI的UCC27511DBVR、
slkor萨科微的驱动IC/SL27525对标替换TI的UCC27525D、
slkor萨科微的驱动IC/SL8402对标替换ON安森美的NCV8402、
slkor萨科微的驱动IC/SSL27523对标替换TI的UCC27523、
slkor萨科微的led驱动IC/SL4139对标替换ON安森美的CAT4139、
slkor萨科微的led驱动IC/SL401对标替换IR品牌的BCR401、
slkor萨科微的功率电子开关SL3405G对标替换IR品牌的BTS3405G、
slkor萨科微的时钟芯片关SL8025T对标替换Epson的RX-8025T、
slkor萨科微的时钟芯片关SL8563T对标替换nxp恩智浦的PCF8563、
萨科微slkor光耦6N136对标替换AVAGO安华高,FAIRCHILD仙童的光耦6N136,6N136M、萨科微slkor光耦6N137对标替换AVAGO安华高,FAIRCHILD仙童6N137。
宋仕强说,萨科微半导体具有国际化的基因,早期就从韩国延世大学引进了碳化硅功率器件技术团队,又结合了清华大学毕业的海归技术人员,供应链也遍布世界各地,员工也来自于世界各地,萨科微半导体与金航标电子公司一起为世界客户提供配套服务。萨科微Slkor(www.slkoric.com)和金航标Kinghelm(www.kinghelm.net)海外官网采用全世界绝大多数人可以看懂的104种语言,展示萨科微的产品和相关信息!
Slkor萨科微(www.slkoric.com)官网右上角104种语言切换
萨科微公司的"Slkor"品牌半导体通用料在深圳市华强北大卖。M7(SMA)、AMS1117-3.3(SOT-223)、AMS1117-5.0(SOT-223)、SS34(SMA)、SS36(SMA)、SS8050(SOT-23)、SS8550(SOT-23)、2N7002(SOT-23)、bat54c(SOT-23)、SD12C(SOD-323)、ZMM5V1(LL-34)、LL4148(LL-34)、SMBJ6.5CA(SMB)、SMBJ5.0A(SMB)。萨科微"Slkor"品牌的SL系列可控硅产品BTA06-800B、BTA08-800B、BTA12-600B、BTA16-800B、BTA24-800B、BTA26-800B、BTA41-800B、BTA41-1200B、BT136S-800E、BT137S-800E、BT138S-800E,SLKOR萨科微(www.slkormicro.com)的MOS场效应管sl2301、sl2302、sl2n7002、sl2304、霍尔开关传感器SL1613-SL、SL1625-SH、SL1613-SH、SL1603、SL1605等型号,与金航标Kinghelm(www.kinghelm.com.cn)作为生产厂家研制的chip陶瓷蓝牙天线KH2012、KH3216、KH5220、KH6010等,还有金航标的弹簧顶针,都可以同时应用在tws蓝牙耳机等上面。比如在tws蓝牙耳机市场,金航标与萨科微的"Kinghelm"和"Slkor"这两个品牌和产品实现了两轮驱动的发展模式。
深圳市金航标电子有限公司,是国家高新技术企业,是"中国卫星导航定位协会"、"中国信息产业商会"、"广东省连接器协会"会员。金航标从事无线信号收发、电子信号连接器及互连系统产品的设计、制造、销售和技术服务十多年,技术团队来自清华大学和电子科技大学,吸纳优秀海归人才,深耕微波射频技术领域,联合高校成立研究机构。金航标获得了多项发明专利,已取得ISO9001认证和RoHS、REACH认证。IATF16949汽车质量体系认证,UL、TUV等认证在申请中。金航标总部位于中国深圳市,兼顾技术、成本、管理、效率和可持续发展。东莞塘厦实验室全电波暗室、网络分析仪、高低温测试柜等仪器设备齐全,可进行高低温、双85等测试,独立完成产品的检测、调试和打样,模具、注塑、机加工、电镀、冲压、线束组装等技术岗位配备齐全,可快速完成高性能且高可靠性产品的研制。
Kinghelm金航标公司天线连接器产品系列
金航标kinghelm的SMA半牙板端座子KH-SMA-K513-G、IPEX天线底座KH-IPEX-K501-29、RF射频连接线KH-RFID-20-BQ等连接器产品,可直接替代村田(MURATA)、广濑(HIROSE)同类连接器接插件产品,还可以应用于GPS导航、车载定位、GPS北斗定位设备等。金航标Kinghelm的kh系列产品,可直接替换国外村田MURATA等天线品牌。应用于苹果AirPods、华为、小米、三星、漫步者等,涵盖高通(CSR)、恒玄(BES)、MTK的络达(Airoha)、瑞昱(REALTEK)、炬芯(Actions)、艾迈斯(ams)、杰理等产品和方案,蓝牙耳机tws的搭载无线标配的充电盒,包括Anker、B&O,Broadcom博通等品牌,还使用萨科微Slkor的电源管理芯片ic和电池管理芯片等产品!

人工智能(AI)助力萨科微半导体加速国际化
2025-03-19
267
近年来全球科技产业快速发展,人工智能(AI)已成为科技竞争的制高点。随着ChatGPT、国产豆包和DeepSeek等大模型掀起的热潮,AI被提升为国家战略纷纷抢占技术高地,金航标kinghelm和萨科微slkor(www.slkoric.com)也要求全员会使用大模型提高工作效率,以提高公司的核心竞争力。在推动萨科微半导体出海这方面,人工智能(AI)也为我们立下汗马功劳。以下这篇文章《萨科微出海逆势突围记 当半导体遇上"海王"战术与社媒狂魔记》,是清华大学的"天才成年"倪枫博士使用AI大模型,结合萨科微品牌出海的情况导入老祖宗的国学智慧来撰写的,非常有感染力。我们金航标和萨科微的同事们都感慨说,人工智能(AI)比我们自己还了解我们自己。
Slkor萨科微国际化宣传图片(一)
萨科微出海逆势突围 当半导体遇上"海王"战术与社媒狂魔记(正文):
为什么萨科微slkor(www.slkoric.com)能成为近两年业绩逆势上涨的科技公司?这几点尤其引人深思。就像苏格拉底说的:"逆境是磨练人的学府",这家由华强北宋仕强执掌的科技新贵,硬生生在芯片行业的凛冬里上演了一出"冰与火之歌"。
Slkor萨科微国际化宣传图片(二)
一、"郑和舰队"出海记:半导体版大航海时代
当同行们还在国内市场"内卷"时,萨科微已化身现代郑和,带着"SLKOR"的旗舰扬帆出海。从东南亚新的电子集散地到德国慕尼黑电子展,这支"芯片舰队"玩转了地缘持续盈利发展。就像马可·波罗游记里的东方见闻,如今欧美工程师们也在传颂着中国芯的性价比传说。萨科微2024年海外营收暴涨67%,这哪是做通常意义的生意,分明是在上演《权力的游戏》——凛冬将至?宋仕强笑言:不存在的!
Slkor萨科微国际化宣传软文
二、社媒狂魔的"数字魔法"
当传统企业还在用产品手册和黄页"打猎"时,萨科微已在短视频平台玩起了"芯片脱口秀"。B站技术宅男、LinkedIn极客、油管发烧友,统统被纳入"电子狩猎"的目标。从华强北战斗中突围的宋仕强深谙凯文·凯利的"1000个铁粉理论",硬是把萨科微枯燥的MOS管、电源管理芯片等产品和技术参数讲成了科技相声。宋仕强某次直播讲解IGBT技术,弹幕狂刷"宋老板再来段贯口",这波操作堪比诸葛亮草船借箭——用流量的东风圈中了订单的靶心。
Slkor萨科微国际化宣传图片(三)
三、"全营一杆枪"的订单打法
拿破仑说"不想当将军的士兵不是好士兵",在萨科微的每个员工都是"订单狙击手"。从研发到客服全员配发"数字罗盘",客户需求像烽火台般实时传递。某次韩国客户凌晨询价,市场部秒回方案;技术组视频会议"云诊断",深圳龙华的仓库连夜出单——活脱脱现代版"八百里加急"。这种《孙子兵法》式的协同作战,体现了"上下同欲者胜"的道理,也是华为提倡的"力出一孔利出一孔"。据统计,这套打发让萨科微的订单转化率飙到89%,比行业均值高出个"珠穆朗玛峰"。从"芯片红海"杀出血路的萨科微,就像《三体》里突破黑暗森林的星舰。当别人在寒冬里瑟瑟发抖时,他们用"海陆空"立体战术上演着科技界的"热辣滚烫"。正如《周易》所言:"穷则变,变则通,通则久",这家把"卷"字刻进DNA的企业证明:在半导体江湖,没有逆袭的剧本,只有敢为天下先的玩家。(正文完)
萨科微产品上线四方维的datesheet5平台
宋仕强接下来补充说,移动互联网的飞速发展推动电子商务的崛起,海外市场的拓展不再局限于传统的线下渠道,而是更多地借助线上平台的构建与优化,以实现品牌的渗透率和样品的到达率。这样的背景下,面对全球市场的竞争激烈,萨科微slkor和金航标(www.kinghelm.com.cn)总经理宋仕强在海外市场的蓝图布局中,充分利用互联网这一利器,打造了专业的推广团队并率领团队摸着石头过河不断积累经验,不断探索萨科微slkor(www.slkormicro.com)的国际化道路,在2024年取得了斐然的成绩。
Supplyframe四方维平台注册工程师数量
未来,萨科微准备与四方维平台(Supplyframe)展开合作,在网上建设生态。相关产品、相关资技资料在四方维的datesheet5/集成电路查询网上线,与世界各地1200万工程师的距离拉近,有助于萨科微产品和品牌的触达!萨科微slkor还积极利用谷歌广告进行精准投放,通过对目标市场的深入分析和用户画像的精准描绘,公司能够准确地将广告推送给潜在的客户群体,有效提升了广告的转化率和回报率。根据推广团队的数据,萨科微slkor的谷歌点击量月均达3000次,谷歌搜索展示量月均更是高达20万次,这不仅极大地提高了品牌的曝光度,也为公司带来了大量高质量的询盘和订单。
萨科微海外团队团队的社媒营销
除了专注于本部团队的建设,金航标和萨科微还与有欧美客户的代理商一起发展,如环宇芯城罗银良先生就是萨科微的战略合作伙伴。在与欧美客户合作时,罗银良也敏锐地察觉到了国产芯片的市场潜力,他认为国产品牌将在未来5到10年迎来崛起的机遇,毅然选择代理国内知名品牌萨科微"slkor"和金航标"kinghelm"品牌的产品,他说:"萨科微和金航标在国内市场已经具有较高的知名度和市场份额,我们和原厂一起努力,未来在国际一定会崭露头角。"
环宇芯城的萨科微代理证及川渝同芯会奖杯
目前,环宇芯城正在积极与国外终端客户推广萨科微和金航标的产品,罗银良先生希望通过自己的努力,能让更多的国外客户了解并认可中国芯片,他的愿景是"将中国的芯片销售到全世界"。

贸易战中的华强北,什么企业可笑傲江湖?
2024-03-07
263
中美贸易战愈演愈烈打的难分难解,著名电子元器件市场华强北距炮火最近,这对二手老板娘们的生意影响非常大,。"你小子想薅中国的羊毛,我们姐妹们就要揪掉你的的黄毛!不,金毛!哼!把你变成像波哥和金航标老宋一样的光头!不,秃头!哼哼!!"但老板娘们气归气,生意怎么办呢?大事情还得要当家老板们拿主意呀。
华强北何去何从呢,各企业该怎么应对?要怎么样调整和转型?磨刀不误砍柴工,我作为华强北最能扯蛋的地摊经济学家,为了我们1688网店的引流,金航标kinghelm老宋先给大家分析分析,再看看怎么办呀。
华强北电子市场的功能为这几方面:
一.产品展示信息交流。以前信息流通和交通都不顺畅,很多前店后厂和异地的企业在这里做展示和销售,这是华强北柜台和铺位的基本功能。各大企业在这里有形象店或旗舰店,以前夏普Philips爱华sony西门子,近几年小米huawei苹果OPPO等也纷纷在这里打擂台。
现在企业自己有官网、有在阿里巴巴店和京东的店面、还有各细分行业的电商平台,消费者不出门就可以了解得七七八八,差点体验和感觉了,现在华强北这个功能逐渐弱化。
二.商务对接。客户来华强北选到合适的产品后,下一步就要和老板娘们谈价格货期账期交付等交易细节了。有了QQ和微信,通过网站的货描等功能,可以实时远程看到图片技术参数再沟通,材料选型的研发维修工程师发烧友采购员人等就可以避免挤一身臭汗到华强北一趟了。电商平台体验越来越好,移动通信的发展更是把在线交易推到了高潮。为大家节约时间提高效率同时,也减少了到华强北的人流量。
金航标kinghelm在1688商城的产品
三.库存和交割。电子元器件货值高不占地方,华强北每个柜台都可以摆放值好多钱的现货,生意做的大的商家还在华强北附近有仓库,随时可以快速让小弟送货过来。可以说,华强北是电子料大仓库,,在禁运的时候是有效缓冲区,也蓄水池,可以满足为客户快速交付的需求。华强北有全中国最密集的的银行网点,鼎盛时每天的现金交易额近10亿。拖着货比人高一头的平板车送货的小弟和晚上物流点堆积如山的货物,是华强北标志性的风景线!
华强北的"标志"快递小哥
四.电子硬件生态链。华强北背后有全球最齐全成熟的电子硬件产业链。在华强北,花几百块钱半天就可以组装出苹果手机,最新款的华为手机,在公开销售的前两天就可以拿到货,世界各地最新款的数码产品不出三天就可以找到仿造品,一些老设备维修用的X86等芯片华强北也有供应。这是华强北的核心竞争力,经常有全国各地的发烧友甚至外国人来华强北找各种型号的芯片,也是华强北人潮涌动的原因之一。
华强北是生态链的关键节点,牵一发动全身呢。深圳好基友东莞还是华强北老板们的加油站,还有标准化工业管理和流水线作业为华强北的商家服务。
五.售后维保。这是电子电器产品服务必不可少的重要环节,各大小品牌在这里都有维保点,提供了方便也带来人气。我同学当年就是润讯通信维修BB机的部门老大,后来转为做中兴手机的维修去了,但是经营地点还一直是在华强北赛格科技园。洋品牌大品牌的服务窗口维修点也大多扎堆在此。
六.商圈功能。抛开上面的功能外,华强北还有其他商业配套。有万佳百货、茂业商场、嘉华外贸市场、顺电、女人世界、苏宁电器、小吃一条街、群星的士高等。他们不但自带流量包,也方便客人带着家人朋友一起,在办完事逛完街后就地吃喝玩乐一条龙消费,把他们包包里面的米米全部留下,也是华强北的魅力所在。华强北还一度是电子行业的朝圣地,深圳市的旅游热点。
萨科微SLKOR在1688商城的产品
华强北电子市场的模式,是当年国际产业大转移的背景下,中国经济粗放型发展对电子元器件旺盛而多元化需求,和深圳人民创新了地产产权制度的产物。华强赛格新亚洲等电子市场的小柜台都来源于此,让华强北成为自发形成的有效市场,成为深圳乃至世界有名的商圈。虽然华强北的硬件设施越来越完善,交通越来越便利,但是因为上述商业要素的变化,呈现越来越多的危机,不创新不变化不行了。
华强北的电子分销模式,因门槛低无核心竞争力,不断有新人进入,如有原厂技术背景、代理商的渠道背景、方案商的产品等,给传统分销商带来很大的压力。有了B2B网站等模式,市场信息越来越对称,原厂、代理商和客户的信息交流越来越频繁,分销商很难一下子从信息单一的生态链中反应过来,就更加麻烦。
在特朗普大打中美贸易战的情况下,加速了华强北旧模式的衰落,但是促进了华强北转型和发展。我前几年就在"北斗专家"公众号的系列文章中详述了华强北的经营模式、盈利点、发展路径,大家可以找来看看。
我的朋友圈这几年发生了很多变化,华强北的老板娘们很多转型变成二手老板娘了。有的卖保险卖红酒卖茶叶了,有的做微商卖面膜口红防晒霜了,还有两位去搞直播了,一位因脸上粉打的太多,还一位粉多还没有抹均匀被我拉黑了。她们感叹着"红颜易老,老公易跑,转型难搞,对手是谁都不知道",确实是比较苦闷呢!
也有部分华强北老板们老板娘,他们洞悉商机与时俱进快速迭代和转型,产品和企业都越来越好,是华强北的主流,也代表中国民营企业的未来。我把他们发展模式整理出来,供大家参考:
一.分销商向产业上游发展到原厂
1.华冠"HGSEMI"半导体林周明。华强北人称明哥的林老板,军人出身为人豪爽是有名的酒神,以前经常用茅台把我灌醉。他当年是国半半导体的销售冠军,已叫"头牌"。在淘到第一桶金后,砸下大部分身家成立了广东华冠半导体公司。华冠从元器件封测做起,凭着潮州人吃苦耐劳精神和军人坚韧不拔的意志,现在做的风生水起了。
2.美隆"sup"电子陈海升。陈总从在赛格广场做贸易起家,自1998创业以来一直认认真真一丝不苟,"sup"美隆品牌的影响力和生意都蒸蒸日上。美隆拥有成熟的无铅化技术,健全的质量管理体系,从研发设计到生产运输,每个环节都严格遵守高质量标准,以确保产品的一致性耐用性和服务的及时性规范性。公司目标是成为"领先的中国电阻电容服务商"。
金航标kinghelm在1688商城的产品
为加强护城河,陈总自建大型物流仓储基地,也在做以阻容感为主打的电商平台油柑网(youganw.com),致力于服务好中小批量采购群体,提供原厂正品、技术咨询、急速发货等服务,构建健康生态圈。特别要表扬的,是陈总的产品和人品一样过硬,在家庭建设孩子教育方面也非常棒,是我们学习的榜样。
3. 科信"KEXIN"电子柯氏兄弟。科信电子是柯燕东燕周兄弟于1987年成立的。由华强北起家,发展成为集研发、制造、销售为一体的国家级高新技术企业,拥有一个省级的研发工程中心和5家全资子公司。科信工业园区占地5万多平米,有职工300多人,在行业中率先引进日本的先进半导体封测设备,拥有生产线29条,主要生产MOS管等功率器件,为打破半导体行业的国外垄断做出了贡献。
4.航顺"Hangshun"电子刘吉平。刘总是2013年由上海滩闯荡到华强北,他分析华强北的贸易模式可能不长久,就决定和朋友一起研发32位的MCU,打造自己的品牌"航顺"。已量产了ARM架构为内核的M0、M3、M4版本的32位MCU,产品的软硬件全兼容全替代国外品牌,中航集团旗下中航联创基金已完成A轮战略投资,广州心心相印基金跟投。航顺口号是:"品质坚如磐石,中国人用中国芯"。
上述前三家潮州大佬的代表,采用重资产的模式,先从封测入手,再逐渐往IP设计应用方案等渗透。同样的还有金大鹏、合科泰、金誉、福斯特等企业,都发展的非常好,做晶振的扬兴科技也是走这个路子。航顺刘总是现在流行的fabless轻资产模式,自主研发生产外包,但是做品牌建生态建渠道还是非常不容易。我看刘总没日没夜的像打了鸡血似的打广告跑客户非常辛苦,所以帮他吹一下,创业者相互支持嘛!
二.微创新跨界发展
以前华强北的业态是单一的贸易倒买倒卖,现在有的企业也在多元化探索和发展。有的在文化战线做自媒体,有的在互联网基础上进一步拓展,有的提供解决方案提供增值服务。
1. 自媒体公众号"芯师爷"和Jason Fan。Jason Fan(范祎)是新加坡安达科技的老板,华强北最喜欢买单的大哥,我是他最关照的小弟,安达科技做全世界紧缺料调货的,布局非常广。"芯师爷"的初衷华强北兄弟们自娱自乐的平台,我年轻时写的段子都是在这里发表的。但Jason兄弟玩什么都喜欢玩到最好最嗨,所以他做的如"今日芯闻"等几个公众号非常有影响力,广告费都接到手软了。
2. 自媒体公众号"ittbank"和吴绍文。"ittbank"号称华强北数据库,我朋友老吴是好色的摄影高手,也是华强北第一代电子发烧友。华强北的信息非常分散多元而凌乱,ittbank几乎包罗整理了行业有关的数据,他们的排行榜涵盖众多细分行业,是参照物标准。老吴提供的优化设计方案的资讯,为处理工厂库存呆滞料尾货提供了新的解决方案和思路。
3. "华强云仓"与华强网团队。华强网是元器件B2B电商平台的大哥好多年,现在刘总和华强网团队,凭借华强集团华强网在电子行业布好的生态,开始经营新项目"华强云仓"。初步了解,该项目可能会以会员制参与经营与现货备货加上快速配送的形式,再导入华强网和华强旗舰店的庞大流量,会成为微创新的典型案例。我们萨科微SLKOR的系列通用电子料会先上架,请大家拭目以待吧!
4. 微科信息技术和吴光松。深圳市微科信息技术有限公司,专注于卫星定位及物联网,是国家级高新技术企业,掌舵人吴光松是位华强北老板娘们喜欢的客户兼当红炸子鸡。吴总早期在华强北做贸易,历经十年的发展,开工厂、软硬件研发、知识产权布局、发展成为一站式物联网行业系统解决方案,经历了几次重大的转折和转型,每一次都是绞尽脑汁的探寻、思索与创新。尽管在北斗gps行业内做的不错了,但是微科人如履薄冰,一直问自己:"10年以后我们是个什么样的公司呢?"
微科信息和金航标电子kinghelm的产品互补,客户趋同,一直以来相互呼应配合的非常默契!
三.代理商模式
比起华强北的传统贸易模式,能快速做大做强的是代理商模式,但是找到大树依靠很重要。据中国半导体行业协会统计,2019年1-6月,中国集成电路产业销售额为3048.2亿元,同比增长11.8%。出口集成电路金额457.5亿美元,同比增长17.1%。进口金额1376.2亿美元,同比下降6.9%,可以看出集成电路国产化是大风口。金硕微的小马哥依托国产发展的大趋势、瑞彩电子科技的蒋总抓住移动通信和物联网的风口,业绩增长都非常迅猛。
1. 金硕微科技"华强北小马哥"。深圳市金硕微科技有限公司成立以来,营业额以每年倍数的速度成长,小马哥马应锋是华强北潮二代的领军人物,金硕微是一家极具竞争力和大发展的公司,取得三星、厚声、华德、欧菲光等知名企业的销售代理权,争取为客户提供一站式供货服务。金硕微为原厂与客户之间建立了高效沟通的桥梁,陪伴原厂客户一起成长!
2. 瑞彩电子科技和蒋向阳。瑞彩电子经过十多年的发展,成为提供移动终端产品、云端连接和移动通讯系统方案解决商。他们抓住了风口,代理的"华为海思"和"移远"的物联网模块、金航标kinghelm的北斗GPS天线,业绩增长如滔滔江水呀,这也成为蒋总在通讯物联网发力的关键支点!司瑞彩电子还帮我们把金航标kinghelm的4G天线导入了中车集团呢,现在开始小批量试产了。
老话说,忠不忠,看行动!老宋认为,企业行不行看老板愿不愿请客买单。小马哥发展的好,和他喜欢请我和Jason fan喝茶有关,蒋总生意蒸蒸日上,是请波哥喝五粮液多次的结果呀!
萨科微SLKOR在1688商城的产品
四.传统商业的威胁者--电商
对很多企业来说"做电商者活,无电商者亡",干还是不干呢?是个大问题。电商平台是大风口,吸引了各路资本。前几年的B2B平台做到了信息和资源对接,但无法解决产品的渠道、质量、交付、配套服务等问题,所以日渐式微在此不表。现在的平台从B2B发展到的综合性B2M、F2B、M2B等各种平台和模式,从轻资产到重资产,从综合型布局到深耕细分市场不一而足。先来看看我们身边的几家综合性电商平台!
1.立创商城(www.szlcsc.com)和杨林杰。立创商城成立于2011年,致力于为客户提供一站式电子电子元器件线上采购服务,4小时闪电发货。立创拥有1万多平米现代化元器件仓库,现货库存超20万种,集团电子全产业链自营服务涵盖:在线EDA(LCEDA)+行业领先的PCB打样/中小批量+元器件商城+钢网制造+SMT贴片+电子设计教育及方案。立创商城所有元器件均从原厂或代理商渠道采购,保证了原装正品,为广大工程师及采购人员解决了元器件样品采购、小批量采购的痛点。他们占地几百亩的物流基地,可以解决快速发货等问题,是学京东的重资产布局,也是核心竞争力。
立创商城在杨总的带领和张银莹的辅佐下稳扎稳打,知名撰稿人吴波、专业人士张继等加入后,就如贾会计说的"生态化反"了,成为作风实在善打硬仗的强组合。上半年获得红杉资本等2.5亿元现金加持后发展迅速,发货速度、SKU、营业额等指标都飞速上升,呈现势不可挡的势态。
金航标kinghelm和萨科微SLKOR的产品在立创商城的产品种类sku超过130个,销售额也节节攀升,我们就坐上他们的大船借力发展了,在这里表示感谢!
2.猎芯网(www.ichunt.com)和常江。猎芯网是由深圳市猎芯科技有限公司开发运营行业领先的全球元器件一站式采购商城,领军人物是常江和梁耀。猎芯网于2015年7月上线,已经获得著名VC经纬中国、五岳华诺、京东战投、海通证券等多轮投资,是本土崛起的元器件知名电商。通过整合上下游资源,提供开放平台、联营、自营、PCB快板、SMT贴片、全球交付等整个交易环节的全闭环一站式服务。
大家还不知道,当年老宋和老常同学在华强北调戏二手老板娘们,一唱一和配合默契有很多经典骚操作,有黄金搭档的美誉。现在他的搭档是梁哥了,他们一个主外一个主内,发展的非常好。
3. 云汉芯城(WWW.ICKEY.CN)与曾烨。云汉是个非常有诗意和空间感的名字,云汉芯城也是行业领军企业,2018年荣获上海市松江区"企业技术中心"、"中国产业互联网独角兽企业"等荣誉。凭借在平台多年的积累,数据量和覆盖面比同行遥遥领先,数据库SKU超8600万,基本可满足制造业在研发试产阶段对参数选型、智能搜索和一站式采购等多元化服务需求。注册企业用户数超30万家,授权合作服务商超200家,2018年销售额超10亿元。
曾烨是我在上海的兄弟,他的副手李剑锋是我徒弟,向我学习讲段子,他的小目标是用段子为上海石库门的老太太们下半生的娱乐服好务。曾烨告诉我,ICKEY的新业务是运用自主开发的人工智能引擎和IDPE/ISPE等技术,为电子制造业的研发人员提供BOM智能选型、国产器件替代等技术服务,为提高研发创新效率、带动电子产业链和促进国产元器件的快速发展努力!
4.华芯商城(www.hxbuy.com)和赖泽联。成立于2016年8月,目前产品集中在消费类电子的电源类通用电子元件的销售。赖总是非常勇于创新的,凭借扎根华强北多年的人脉和产品优势,从半导体产业的销售端切入,深度布局全产业链。从渠道、研发、生产、品控,到从仓储到智慧物流,从线下到线上全面掌控深度服务。
华芯商城致力于打造集元器件和模组的设计、研发、生产、销售、供应链服务于一体的F2B模式,成为半导体行业互联网模式标杆企业,全方位、多维度为广大客户提供华强北特色的一条龙服务!
因为篇幅的关系,英唐智控旗下的优软商城、宋俊伟的采芯网等做的电商平台各具特色各具优势,我就不一一介绍了。你到华强北的街头走一走,还会发现很多的小店铺,也在做电商呢。
在我写这篇文章的时候,九洲电子的电商事业部给我们金航标公司打电话,邀请我们的金航标kinghelm的品牌的系列北斗天线等产品进入他们的电商平台电子之家(www.jzic.com);华强北龙维ERP软件的老龙兄弟,也为客户搭建平台一体化的系统,比如有IC摸一摸(www.icmomo.com),IC骚一骚(www.icsoso.com),都是龙维erp为他们搭建的销售与管理一体化平台。
谁说国家队发育慢呢?中电港就在名如其人的掌门人毕风雷的带领下快速开辟了独立的电商平台艾矽易www.iceasy.com,布局了阿里巴巴生态天猫旗舰店和微信生态等,完完全全的深圳速度嘛。金航标kinghelm和萨科微SLKOR的产品入驻了,iceasy开的第一单就是销售slkor的mos管sl3401s。和中电港打交道的过程中,体会到中电港美女员工素质高反应快服务好,这和他们写字楼搬到东莞有关系吧?
华强北的兄弟们也积极拥抱电商。前几天百度微电子吴迪请我吃饭,说他们在1688店的销售不错,是公司的另一个增长点。宇翔达电子在1688开了超级店,每天可以开几十单呢!羊总说,开网店就是前期投入的精力和资源会多一些,理顺了就好了。宏图伟业、世联芯等也在阿里巴巴开了商城。
金航标kinghelm的代理商大光科技公司,也在1688开店了,才两个月kinghelm品牌就已经升级阿里巴巴的工业品牌了,发展速度非常快。运营经理小贾同学,他写的在金航标kinghelm品牌用定位和大数据思维做电商的文章被阿里头条采用了。做电商我们也是认真的,有客官买北斗GPS天线等产品,请在1688店或1688工业品牌站搜索金航标/kinghelm/天线连接线即可!
还有叫什么东的平台生意也还行,但这平台的老板花钱太大手大脚了,去两分钟就花了几百亿,我不敢和他做生意了。
世界一直不变的就是变化,华强北也是如此。让人无所适从但不得不拼命适应,是我们的宿命吧。千帆过尽潮起潮落,华强北路在何方?大浪淘沙勇立潮头的企业是哪些呢?我举的例子是一叶知秋管中窥豹,让时间来慢慢回答我们吧!
宋 仕 强 先 生 简 介
宋仕强(Song Shiqiang)先生,萨科微半导体和金航标电子两家公司的总经理,中国电子学会专家库成员、深圳华强北商业研究专家、专栏科普作家。宋仕强从基层技术人员干起,担任过国际地产上市公司CEO,有丰富的技术管理和企业经营的经验,将宏观经济学理论与现实中经营管理相结合,带领公司高速发展!
华强北宋仕强先生(Huaqiangbei Songshiqiang)
宋仕强先生投资的萨科微半导体和金航标电子公司,总部设在中国深圳市,都是国家高新技术企业,萨科微"SLKOR"(www.slkoric.com)和金航标"Kinghelm"(www.kinghelm.net)品牌,享有国际化知名度和美誉度,市场占有率逐渐扩大。深圳市萨科微半导体有限公司,专注新材料、新工艺、新产品的研发,技术团队来自韩国延世大学和清华大学,率先掌握碳化硅MOSFET技术。萨科微已由FABLESS设计公司发展成为集设计研发、生产制造、统解决方案、销售服务于一体的综合型公司。

宋仕强论道 之 经济转型期如何保持增长
2025-07-31
269
宋仕强论道 之 经济转型期如何保持增长
作者:萨科微宋仕强
宋仕强先生在第九届电子产业链资源对接会现场
编者按:宋仕强先生(Huaqiangbei Song Shiqiang),是金航标(www.kinghelm.com.cn)电子和萨科微(www.slkormicro.com)半导体公司的创始人暨总经理,经济发展中心民营和中小企业研究员、中国科学技术协会电子信息专家库成员、中国电子学会专家团讲师、华强北商业研究专家、科普专栏作家,也是首位对“华强北精神”深入研究和“华强北文化”提炼总结的文化学者,被誉为“华强北旁观者”。“宋仕强论道”系列短视频和文章,分享多年学习、生活和创业经验及感悟,包含商业、文学、艺术、哲学、宗教、美学、宏观经济学等内容。本文源自宋仕强先生在2025大佳源电子产业链资源对接峰会上发表的《经济转型期如何保持增长》主题演讲,这是本届峰会第一个分享议题,演讲精彩赢得了现场观众的阵阵掌声和强烈共鸣,并以全球直播形式广泛传播!
宋仕强主题演讲:《经济转型期如何保持增长》
大家好,今天我继续有幸来参加“石榴姐姐”徐红张罗的资源对接会,以下是我宋仕强的几点看法,正是“从实践中来,再到实践中去”,助力我们金航标(www.kinghelm.net)和萨科微(www.slkoric.com)行稳致远,营收连续几年保持高速增长,关键的隐形经营管理数据也在稳步提高,“kinghelm”和“slkor”品牌也在行业和世界范围大放异彩!
宋仕强说增长可以解决很多经济和社会问题,转型期是比较痛苦的。主要特征就是“卷”,就是“好不容易把别人的饭抢过来,但是转身一看我们的锅被别人端走了”。如光伏组件、新能源汽车、储能等中企出海卷到国外卷出天际。比较开心地告诉大家,我运营和管理的两个公司——金航标Kinghelm电子和萨科微Slkor半导体连续3年(2022-2024年)增长超80%!所以我宋仕强有资格跟大家探讨增长的话题,希望大家都能实现增长,最不济也能原地踏步或者下降得比同行少,也是一种胜利。
一、转型期现象
转型期就是说经济低增长甚至负增长,钱越来越难赚工作也不好找,很多人选择了躺平,如上图国外的“葛优躺”。一个现象是企业裁员甚至倒闭、员工失业、老百姓没钱。第二个是债务风险大,社会纠纷多矛盾大不稳定因素增加。经济活动的本质是流通,一个环节出了问题,就会诱发流通的全链条出现更多更大的问题。老百姓不消费社会投资意愿下降,经济陷入恶性循环,大环境会也越来越差,接下来就会出现第三个可怕的现象——“死亡螺旋”。炒股的人都知道“戴维斯双杀”,意思是当投资的公司的盈利能力下降时,每股收益减少股价也随之下跌,让投资者两方面损失,因此被形象地称为“双杀”。如公司的货款收不回来,就没钱发工资付货款,员工会离职闹事,供应商就断货,生产出不来货客户那边又没钱收,银行就会来催贷断贷,通常伴随两口子离婚、高管出走等等,企业不倒闭都难。我们萨科微(www.slkormicro.com)前段时间在华强北又新开了第二个商铺,据说这个商铺前几年的转让费就是70万,现在没有收任何费用就租给我们了。说明以前出得起70万的人,被市场卷死了嘛,民营和中小企业太不容易了。
萨科微总经理宋仕强(左一)参会前接受“知芯苏哥”采访
现在迎来日本人所谓的“第四消费时代”,这是在日本经济泡沫破灭以后出现的情况:A.低消费、低欲望;B.少婚少子,爱上花鸟鱼虫猫狗;C.共享/二手经济火热。举几个例子,现在生孩子、养孩子的成本很高,业余时间怎么办呢?就爱上了猫猫狗狗花鸟鱼虫,宠物市场就火起来了。再看一组数据,如我的那辆雷克萨斯开了17年还没到9万公里,基本就我一个人坐,所以私家车使用率就20%出头,浪费很大的,于是滴滴打车等共享经济也顺势而生。
二、发展的公司
第四消费时代,日本和中国还有哪些公司在发展?日本一个是优衣库另一个是无印良品。优衣库就是以“啪啪啪”在中国出名的品牌,无印良品没有LOGO,一件衣服二三百块钱简单实用。这期间日本松下、索尼、夏普等企业生产外移,这些企业创造的国民生产总值(GNP)基数很大。
看国内,以拼夕夕为代表的低价平台、胖虎、闲鱼等二奢二手经济很火爆。消费降级和用二手货是降低生活成本的方式。去年拼夕夕市值超过阿里巴巴,成为中国第一大电商公司,说明穷人越来越多很多中产阶级返贫了,这也是一个经济现象。
这段时间观察到,我家小区周边新增了3家宠物连锁医院,还提供宠物托管等特色服务,发现他们的生意很好。
三、行业增长状况
以前是包工头,一度成了生产队的首富,我看到10年后建筑行业没得干,所以我选择转型。好消息来了,现在我们所在的电子信息行业也在增长,我的两个公司——萨科微和金航标也在增长,金航标kinghelm(www.kinghelm.net)是做连接器和北斗bds天线的,和国外连接器巨头安费诺、泰科、Molex、广濑、立讯精密、富士康(鸿海)、Yazaki、JAE和国内的贵州航天电器、永贵电器、电连精密技术、长江连接器、长盈精密、信维通信、日海通讯、华信天线等都是业内同行。
我们来看三个数据,就知道电子半导体行业大有可为。一是中国2024年集成电路进口2.74万亿元,比2023年增长11.7%,仍旧是第一大进口商品。举个例子,我出生的时候唯一家用电器是手电筒,到我读初三的时候,家里有了第二个电器是电灯,当时能装个18瓦的老式日光灯管就算很好了,前几天刚买了一台智能扫地机器人,所以我们这个集成电路行业还有得搞。第二个数据是2025年上半年,我国集成电路出口增长20.3%,增长的喜人。现在大量中企都在出海、往外卷,我们金航标kinghelm和萨科微slkor在努力出海,在海外打广告已经花了1000多万元人民币了。还有第三点,2024-2032年,中国PCBA出口由3000亿美元将达万亿美元,这个是我们集成电路的强关联性的配套数据。这些都充分印证了我的第一个观点——“国内外增长强劲”。
我们萨科微的同行企业也在增长。我有兄弟在“圣邦微”当研发部的头头,他说圣邦微增长强劲。润石董事长张明前几天在华强北请我喝酒,他说今年润石也在增长。还有立创商城和嘉立创,据说2024年嘉立创实现营业收入近80亿元、净利润9.98亿元,分别同比上年增长18.55%、35.19%,均保持稳健增长态势。所以经营得好的企业就三点:1、深耕行业;2、生态链做好,3、商业模式好。
第四个广告来了,我们的广告比当年的“计划生育”政策都硬。大家请看—金航标和萨科微两个公司,今年上半年的萨科微业绩增长超30%,金航标超60%。我们金航标(www.kinghelm.net)和萨科微(www.slkoric.com)连续三年保持增长,按照这个态势明后年可以直接上科创板了。接下来是骉鑫集团,骉鑫CEO谢鹏博5月来我们公司交流了,骉鑫集团在转型也在增长,说明转得很成功。还有,华强北做ERP的龙维商软也在增长啊,龙哥虽然是做软件的但是质量也非常硬。龙维的龙哥经常和我配合讲段子,跟着我宋仕强排华强北第三位。
看上图,金航标今年3月份是环比增长了38%,淡季仍旺源于长期积累和持续努力,6月份增长了20%。图三是庆功宴,我们公司比较装逼,庆功宴都喝五粮液。“萨科微”也在增长,请看我们的数据支撑:
A.立创商城SKU增加1200个;
B.广告投入增加30%,研发投入增加80%;
C.员工增加20名,人效提升35%;
D.官网升级(功能增50%,流量增30%);
E.ERP升级、SaaS升级;
F.海外询盘量增加120%。
我宋仕强认为,我们做企业还是要讲良性循环、良性增长,比如我们在立创商城的SKU增加了1200个,这是健康标签SKU总量1200+,我们原来是有6000多个,这个同比增长达到20%左右,所以拉动公司增长是肯定的。广告投入增加了30%,研发投入增加了80%,员工增加了20名,人效提高了35%,这些数据都是我们自己统计、比较科学的。还有我们官网升级(各种功能增加了50%,流量增加了30%),加上我们金航标和萨科微是靠段子营销的,段子写得好的同时,又把产品做好了,所以有资格在这里谈增长。
创新+互联网营销,我们公司四大官网矩阵(www.kinghelm.com.cn/www.kinghelm.net/www.slkormicro.com/www.slkoric.com)每天有20万人次的浏览量,并且我们网站的留存率非常之高,达到4分多钟,因为大家都喜欢看段子。我们的海外询盘量增加了120%,金航标和萨科微在海外打了1000多万元的广告了,这里我再打个广告,近日,深圳市萨科微半导体有限公司(www.slkormicro.com)在企业形象知识产权领域取得重要成果。“AI机器人”吉祥物卡通人物形象(商标注册证号:82550616)和其机器人“力量小子”名字(商标注册证号:82550880)正式获得国家知识产权局第9类(国际)商品注册。这标志着萨科微在品牌建设与知识产权保护方面迈出坚实一步。“萨科微AI机器人”活泼可爱,底色为红,用集成电路图片作为吉祥物眼睛,凸显行业和产品特征;憨态可掬笑口常开,寓意生意兴隆其乐融融,团队开朗乐观活泼!接下来萨科微还将开发出3D形象的吉祥物和一系列小礼品等,这也是传播萨科微企业文化的载体,也有助于国际友人通过有趣、好玩的方式了解萨科微的文化、产品和经营管理团队!你看我们不仅注册成功了,还把萨科微的吉祥物搞得很好玩很有趣,这样才有创意创新。
四、同行案例
社会发展和变革有一个规律,不是最强大的活下来,而是主动变革、自我更新更快的物种或组织能活下来,,如恐龙就死光了而蟑螂活下来了,这个道理对于经济转型期也适用。骉鑫集团,他们原来做电子元器件外贸的,现在定位为全球领先的连接器应用方案与供应链服务商,要致力于实现“让世界工厂用上中国制造连接器”的愿景。现在成为我们金航标kinghelm(www.kinghelm.com.cn)的全球代理商。今年以来,骉鑫集团捷报频传,不仅正式成为荣电集团电子元器件集采平台服务商,负责荣电集团产品方案设计、PCBA板、电子元器件采购业务;还成功谱写了“3个月内连续拿下10多家国际国内一线连接器、电感、传感器品牌代理”的新篇章,产品主要应用:汽车领域、工业控制、AI智能、通讯领域、低空经济、储能领域。接下来,我们金航标和萨科微也会和骉鑫集团达成战略合作。可见,骉鑫集团是适应规律主动转型成功的典型案例,其深层次的逻辑是创新求变,他们几个领头人这几年都很辛苦,2024年涅槃重生,2025年破局突围、转型非常快,所以要想过得有尊严,就要变革,自强不息、厚德载物。再说龙维商软,他们是做ERP的,原来的客户多是华强北的小贸易商和一些小微企业,已经垮了好多了,客户基础出现问题。这怎么办?我给他们分析说要么在原来的业务上增加增值服务,要么开拓新的业务范畴,搞狼性营销抢市场份额,还有就是要建生态。龙哥就经常性请我和朋友们吃饭,这也是个建生态的过程嘛。现在龙维商软发展得很不错。
五、应对之策
合适的应对之策是重中之重,调整战略和心态是首要的。一是做长期主义,拒绝暴利。“暴利”收割行业的时代结束了,且暴利会让人狂妄自大失去正常心态,华强北几位开劳斯莱斯的兄弟都黯然离场了,所以还是踏实稳定干比较好。二是深耕本行业,现在还稳步发展的企业都是行业沉淀好多年的,他们坚守公司战略,不想着一夜暴富赚快钱。三是做精做细,微利时代,企业就是要向管理要效益,必须做好精细化管理,抠细节控制好成本,企业才能有点钱赚。四是学习和创新。我们金航标Kinghelm和萨科微Slkor公司打造学习型组织,培养学习型员工,提高人效,推动企业管理微创新大发展。企业在原有的基础上做一些微创新、微调整,利用互联网思维去做,就能够做好,换言之就是微创新+互联网营销是可以行得通的。五是积累是护城河。我华强北宋仕强认为,企业成功的秘诀和底层的逻辑是重在积累、久久为功,比如我们金航标和萨科微的高速稳健增长正是践行多年的“工作好是为了生活好”的以人为本的理念,及构建的管理体系和组织行为机制,同时确保公司知识工程、组织架构、质量管理体系、工作流程、激励机制,从产品研发到现金回笼的高效商业闭环实现效率高高、分钱多多。
相对竞争,简单点说就是竞争是相对的,你只要比其他竞争对手强一点就行了,我归纳出了六个要点,分别是大打小、快打慢、精打粗、静打躁、简打繁、高打低,可以理解为:商业竞争中一直都是大鱼吃小鱼、快鱼吃慢鱼,企业走向精细化管理,就要放弃粗放式管理,静才能成大事,简单才能持久,高效更是王道,对于行业和产品有高维度认知的,会超过只有粗浅认知的竞争者。我们金航标(www.kinghelm.com.cn)和萨科微(www.slkormicro.com)致力于打造简单和谐、高效进取的工作氛围,希望员工们上班努力工作、下班开心生活,这样利于员工们的身心健康和长远发展。
金航标和萨科微:
Kinghelm金航标研制的天线连接器接插件产品
金航标kinghelm(www.kinghelm.com.cn)研发生产的北斗GPS双模天线、Wi-Fi天线和蓝牙天线,射频连接器、RJ45网络接口在新能源汽车广泛使用!“金航标,连接世界”,金航标十多年前就参与北斗“两客一危”项目,为“北斗部标机”提供北斗GPS天线和信号连接器和接插件等产品。十多年持续在射频和微波技术方面深耕,现在的金航标kinghelm(www.kinghelm.net)电子研发的射频信号产品有BDS北斗天线GPS天线、蓝牙天线、WiFi天线、4G天线等;还不断开发出板对板、板对线连接器、板端座子接口、接插件、信号开关配套产品系列;以及汽车线束医疗器材连接线、高速率连接器等产品的开模定制等三大业务板块。
金航标kinghelm(www.kinghelm.com.cn)与萨科微为全球2万多家客户提供产品和技术服务!近日,萨科微(www.slkormicro.com)半导体为了终端客户、代理商方便使用“slkor”品牌的新产品,加强对客户的配套技术服务,推出对应使用的DEMO板,这次推出的型号为SL27517A。萨科微 SL27517A 是一款 4A 单通道栅极驱动,在替代 TI 的 UCC27517DBVR (TI德州仪器)时具备多项显著的优势,主要体现在性能兼容性、成本控制、设计灵活性及供应稳定性等方面。萨科微 SL27517A 在 VDD=12V 时提供 4A 灌/拉峰值电流(对称驱动),与 UCC27517 的 4A 源极/汲极电流能力完全一致,可高效驱动 MOSFET、IGBT 等功率器件,适用于开关电源、DC-DC 转换器等场景。 SL27517A还有宽电压范围,SL27517A 工作电压范围为 4.5V-20V,略优于TI德州仪器的UCC27517 的 4.5V-18V,尤其在低压或电池供电场景(如便携设备)中适应性更强。

为什么AI芯片公司正在越来越像系统公司?
2026-10-14
359
一颗GPU的性能,已经越来越"装不进"一颗GPU里。
如果你今天去看一家领先AI芯片公司的研发组织,会发现一个很有意思的变化。
它当然还有传统芯片公司最核心的团队:
架构、RTL、验证、后端、封装、驱动、编译器。
但在这些团队旁边,越来越重要的部门开始出现:
高速网络、
交换芯片、
集群通信、
系统软件、
服务器设计、
电源、
液冷、
机柜、
数据中心基础设施,
甚至还有专门研究"几千颗GPU怎样一起工作"的系统架构团队。
这已经和我们传统印象中的Fabless公司非常不一样了。
过去,一家芯片公司可以把自己的责任边界画在PCIe接口附近:
我的芯片符合标准,你把它插进服务器,剩下的事情由OEM和客户解决。
今天这个模式正在失效。
因为AI客户真正购买的,并不是一颗GPU。
训练客户购买的是:
多长时间能够训练完一个模型。
推理客户购买的是:
在给定延迟下,一美元能够生成多少Token。
云厂商购买的是:
一个MW电力最终能够变成多少有效AI计算。
一旦客户用这些指标衡量产品,芯片公司就会发现:
决定最终性能的很多东西,根本不在芯片里面。
于是一个非常重要的产业变化开始出现:
AI芯片公司的产品边界正在从Silicon,不断向System外扩。
这也是为什么下一代AI芯片公司,看起来会越来越像一家系统公司。
一、首先要定义:什么叫"系统公司"?
这里很容易产生一个误解。
所谓AI芯片公司变成系统公司,并不是说:
NVIDIA、AMD或者未来所有AI芯片创业公司,都必须自己生产服务器、交换机、CDU、机柜和数据中心。
如果这么理解,结论反而是错的。
真正的变化是:
芯片公司必须对芯片之外越来越多的系统性能负责。
过去可以把产品定义成:
一颗GPU。
后来变成:
一块加速卡。
再后来变成:
一个八卡服务器平台。
现在进一步变成:
一个Rack-scale计算系统。
甚至开始向:
Cluster和AI Factory扩展。
这里真正改变的不是"自己生产多少零部件"。
而是:
你必须控制哪些接口,才能保证客户最终得到预期性能。
所以所谓系统公司,更准确的定义应该是:
能够定义系统架构、控制关键接口、提供参考设计、完成跨层验证,并对最终工作负载性能负责的公司。
电源模块可以外购。
液冷CDU可以由合作伙伴提供。
服务器也可以由OEM生产。
但GPU、网络、供电、散热和软件之间如何组合,已经不能再完全交给别人决定。
二、为什么过去芯片公司可以只做芯片?
因为过去的计算系统,相对"松耦合"。
以传统服务器为例。
CPU通过标准Socket安装;
DDR通过标准内存接口连接;
网卡走PCIe;
硬盘走SAS、SATA或者NVMe;
服务器之间通过Ethernet连接。
各个组件之间拥有比较清晰的标准接口。
因此Intel、AMD可以主要负责CPU。
Broadcom可以主要负责网络芯片。
Micron、Samsung、SK hynix负责DRAM。
Dell、HPE、浪潮等OEM负责服务器整机。
数据中心运营商负责供电和制冷。
这套产业分工能够成立,有一个非常重要的前提:
不同层之间的耦合没有强到必须联合优化。
但AI把这个前提打破了。
原因是今天的AI系统拥有三个非常鲜明的特点:
第一,计算密度极高。
第二,GPU之间通信极其频繁。
第三,一个模型往往必须跨大量GPU运行。
结果就是:
GPU性能、HBM、网络、电源、散热和软件已经无法彼此独立设计。
改变其中一个变量,其他层往往必须跟着变化。
这就是所谓:
Cross-layer Co-design,跨层协同设计。
也是AI芯片公司系统化的真正技术原因。
三、第一个被拉进来的能力:网络
GPU越来越快以后,GPU之间的距离开始成为问题
假设只有一颗GPU。
网络基本不是核心问题。
但如果模型装不进一颗GPU怎么办?
两颗。
八颗。
72颗。
几百颗。
几千颗。
这时候计算问题就逐渐变成通信问题。
例如Tensor Parallel。
一层神经网络的矩阵可能被切到多个GPU上。
算完以后,不同GPU之间需要交换结果。
MoE更明显。
一个Token可能被路由到不同GPU上的Expert。
于是产生大量All-to-All通信。
训练过程中还有:
AllReduce、
AllGather、
ReduceScatter。
这些操作意味着一个事实:
GPU不是独立计算,而是在进行同步计算。
只要其中一部分GPU等待网络,昂贵的Tensor Core就会闲置。
所以网络第一次从"外围设备"进入了AI芯片的核心性能公式。
四、于是芯片公司开始自己定义Scale-up网络
NVIDIA的演进非常典型。
如果只看GPU,会误以为它卖的是越来越强的Blackwell GPU。
但看完整的NVL72系统,产品就完全不是这个逻辑了。
NVIDIA公开的GB300 NVL72参考架构中,一个机柜集成72颗Blackwell Ultra GPU和36颗Grace CPU,通过9个NVSwitch Tray形成完整NVLink域,整个系统的NVLink聚合带宽达到130TB/s。
这里真正重要的不是130TB/s这个数字。
而是:
GPU间网络已经进入GPU系统本身。
过去网络是:
服务器连服务器。
现在Scale-up网络越来越像:
大型GPU内部被"拉长"的片上互联。
只不过原来连接的是一个Die中的计算单元。
现在连接的是不同GPU。
于是芯片架构团队不得不开始理解:
拓扑、
SerDes、
Switch、
Collective Communication、
拥塞、
路由、
链路故障,
以及通信和计算如何Overlap。
这已经明显超出了传统GPU微架构的边界。
五、Scale-up之后,又出现Scale-out
Scale-up解决的是:
几十颗GPU怎样变成一个紧密计算域。
但前沿训练系统往往需要几千、几万甚至更多加速器。
所以还必须Scale-out。
这时需要的东西又增加了:
NIC、
交换机、
光模块、
InfiniBand或者Ethernet、
RDMA、
拥塞控制、
Collective Library、
拓扑调度。
一颗GPU有多快,开始只是第一层问题。
第二层问题变成:
增加一倍GPU以后,实际性能能够增加多少?
假设:
1000颗GPU获得1000单位性能。
扩展到2000颗以后只有1700。
那么Scaling Efficiency就是决定投资回报的重要变量。
这意味着AI芯片公司的竞争指标已经从:
单GPU Benchmark
逐渐变成:
Cluster Scaling Efficiency。
网络团队自然就从配套团队变成了核心产品团队。
六、第二个被拉进来的能力:软件
AI芯片越来越像一种"需要软件才能完成设计"的硬件
传统芯片设计有一个很明显的时间节点:
Tape-out。
芯片流片以后,大部分硬件能力已经固定。
但AI加速器很特殊。
同一颗芯片,最终到底能发挥多少性能,可以被软件显著改变。
例如:
一个算子调用三个Kernel还是一个Kernel?
中间结果需不需要写回HBM?
Tensor Parallel怎么切?
通信什么时候发生?
能不能和矩阵计算Overlap?
KV Cache怎么管理?
Batch怎么组?
不同请求怎么调度?
模型采用FP16、FP8还是FP4?
这些都不是简单的Driver问题。
它们会直接决定GPU利用率。
所以AI芯片公司慢慢发现:
Compiler和Runtime并不是芯片完成之后再补的软件,而是芯片架构的一部分。
七、为什么CUDA真正难复制的并不只是API?
很多讨论CUDA时,喜欢把问题简化成:
"开发者习惯"。
当然,生态惯性非常重要。
但如果只看到API兼容,仍然低估了问题。
现代AI软件栈实际上至少包含:
框架;
Compiler;
Kernel Library;
Communication Library;
Runtime;
Inference Engine;
Distributed Training;
Scheduler;
Profiling;
Debug;
Cluster Management。
而且它们越来越需要知道底层硬件拓扑。
例如:
这个模型应该切到哪几颗GPU?
这些GPU是不是位于同一个Scale-up域?
不同GPU之间的带宽是多少?
KV Cache应该放在哪里?
通信能不能提前发起?
故障以后任务怎么恢复?
所以未来AI编译器面对的已经不只是一颗芯片。
它面对的是:
一个分布式异构计算系统。
这也是为什么软件能力越来越难作为硬件团队的"附属品"。
它正在进入产品核心。
八、AMD的Helios为什么值得观察?
AMD Helios体现的是另一种系统化路径。
AMD在2026年发布的Helios rack-scale方案,把Instinct MI455X GPU、EPYC CPU、Pensando网络以及ROCm软件放入统一的Rack架构,并直接把它定义为面向训练和大规模推理的完整计算、网络与开放软件基础。
这并不意味着AMD必须自己生产Helios所有部件。
实际上它更接近一种:
Rack-scale Reference Architecture。
AMD公开信息显示,Helios参考设计向合作伙伴开放,并计划在2026年下半年进入规模部署。
这恰好说明:
成为系统公司,并不一定意味着垂直制造。
也可以采用:
GPU自己定义;
CPU自己定义;
网络自己定义;
软件自己定义;
Rack架构自己定义;
然后让OEM、ODM和供应商共同制造。
这里控制的不是全部产能。
而是:
系统架构。
九、第三个被拉进来的能力:电源
这可能是AI芯片产业最反直觉的一次扩张。
一家做GPU的公司,为什么最后需要研究数据中心怎么送电?
答案仍然是:
因为芯片功耗已经高到电源架构会反过来限制计算架构。
NVIDIA目前公开的GB300 NVL72参考系统,整Rack最大功率需求可达到约142kW,并配置8个33kW Power Shelf。
100kW以上的Rack意味着什么?
意味着你不能再把供电视作数据中心建设完成之后的配套工作。
因为:
线缆有电流上限;
铜有成本;
Power Shelf占机柜空间;
转换过程存在损耗;
瞬时负载变化会影响供电稳定;
备用电源也必须重新设计。
于是计算密度进一步增加以后,电源系统本身需要改变。
十、为什么行业开始讨论800V DC?
2026年,Google、Microsoft和NVIDIA开始通过OCP推动下一代AI数据中心800V DC供电架构标准化。
OCP给出的核心理由之一非常直接:
随着AI Rack功率不断提高,使用更高电压输送同样功率,可以降低电流,从而减少导体和铜材需求,并支持更高密度系统。
这件事情意义非常大。
因为它说明:
芯片公司的产品定义已经开始触碰数据中心配电架构。
过去产品会议可能讨论:
Tensor Core数量。
现在可能还要讨论:
Rack功率是多少?
输入电压是多少?
电源转换放在哪里?
Rack内部使用什么Busbar?
Power Shelf占多少空间?
GPU负载快速变化时,电网侧看到什么?
这已经不是传统意义上的芯片设计。
这是计算架构、电气工程和数据中心基础设施共同设计。
十一、第四个被拉进来的能力:液冷
为什么液冷正在成为AI系统架构的一部分?
因为任何芯片最终都必须满足最简单的一条物理定律:
输入多少电,最终基本就要排出多少热。
如果一个Rack消耗100kW电力,那么最终就必须处理接近这个量级的热负荷。
空气并不是一种特别优秀的高密度热传递介质。
因此随着GPU功率和Rack密度持续增加,液冷逐渐从"高端可选项"变成高密度AI系统的重要设计变量。
NVIDIA的GB300 NVL72本身就是液冷Rack,并且参考设计已经包括Rack级和Tray级漏液检测。
注意这一点。
一家GPU公司的官方计算系统文档,现在已经需要定义:
液冷、
Manifold、
Leak Detection。
这个变化本身已经说明产业边界发生了什么。
十二、液冷也不是"装一根水管"那么简单
把冷却液送到GPU附近只是第一步。
真正工程化以后会出现:
Cold Plate怎么设计?
流量多少?
压降多少?
进水温度多少?
Quick Disconnect使用什么规格?
不同材料是否腐蚀?
液体泄漏怎么检测?
CDU怎么冗余?
一台设备维修时能不能不停止整个Rack?
不同供应商的冷板和Manifold能不能互换?
OCP的AI系统白皮书已经把Cold Plate、Rack Manifold、快速接头、CDU测试方法、冷却液规范和漏液检测等都列入开放系统需要解决的问题。
所以"上液冷"并不是把风扇换成水。
本质上是增加了一整套:
新的机械系统、新的可靠性问题和新的供应链。
而且冷却能力一旦不足,会直接导致:
GPU降频。
于是热设计最终又回到了计算性能。
这就是AI系统典型的跨层闭环:
GPU功耗上升↓热密度上升↓液冷架构改变↓Rack结构改变↓供电和网络布局改变↓最后又反过来影响GPU能够运行在什么功率。
所以液冷并不是芯片之外的东西。
它已经成为芯片可持续性能的一部分。
十三、第五个变化:系统验证开始比"芯片点亮"困难得多
传统芯片公司有一个非常重要的里程碑:
First Silicon成功。
芯片点亮。
Benchmark跑通。
产品基本进入最后阶段。
但Rack-scale AI系统完全不是如此。
72颗GPU同时工作以后,需要验证的东西可能包括:
GPU;
CPU;
HBM;
NVLink;
PCIe;
NIC;
Switch;
光模块;
Power Shelf;
BMC;
Firmware;
CDU;
漏液检测;
Compiler;
Runtime;
Collective;
Scheduler。
其中任何一个环节异常,都可能让客户看到:
GPU利用率下降。
更麻烦的是,有些问题只有在大规模部署以后才出现。
例如:
100块GPU运行正常。
10000块以后,某种极低概率故障每天都会发生。
单机网络没有问题。
几千节点以后出现拥塞。
单Rack供电稳定。
大量Rack同时进行AI训练以后出现高同步性负载变化。
于是AI系统出现一个非常重要的工程变化:
规模本身开始产生新的故障模式。
这意味着芯片公司的验证团队,也必须从:
Silicon Validation
走向:
System Validation,
甚至:
Cluster Validation。
十四、为什么RAS突然变得这么重要?
RAS就是:
Reliability、Availability、Serviceability。
可靠性、可用性和可维护性。
如果只有8颗GPU,一颗坏掉只是一个局部事件。
如果系统拥有10万颗GPU,即使单颗设备的故障率非常低,整个集群也可能持续有设备处于异常状态。
因此系统真正的问题不再是:
"会不会坏?"
而是:
"坏了以后整个计算任务还跑不跑?"
这会进一步要求:
错误检测;
链路隔离;
GPU健康监测;
自动重试;
Checkpoint;
任务迁移;
Failover;
预测性维护。
所以未来评价AI芯片时,一个很容易被忽略的指标是:
不是芯片能不能跑Benchmark,而是集群一年里有多少时间真正处于有效计算状态。
利用率从90%提高到95%,在一个几十亿美元规模的数据中心里,可能意味着非常巨大的经济价值。
这也是系统公司必须承担的责任。
十五、组织结构于是被迫改变
把前面几个变化放在一起,就会看到一个更深的结果:
AI正在改变芯片公司的组织结构。
过去一家典型Fabless AI芯片公司的核心组织可能是:
架构;
RTL;
Verification;
Physical Design;
DFT;
Firmware;
Driver;
Compiler。
未来则可能需要扩展成:
Silicon
芯片架构RTL验证Physical DesignSerDesHBM先进封装
System
BoardServerRackSI/PIPowerThermalLiquid Cooling
Network
NICSwitchScale-upScale-outCollective Communication
Software
CompilerKernelRuntimeInference EngineDistributed TrainingScheduler
Infrastructure
Cluster ManagementTelemetryRASDeploymentValidation
这已经不再像传统Fabless公司。
它越来越像:
计算系统公司。
十六、但这里有一个巨大的代价:组织复杂度爆炸
系统化听上去很好。
现实却非常残酷。
因为每增加一层产品边界,都会增加新的组织接口。
芯片团队需要和封装团队协同;
封装需要和Board团队协同;
Board需要和电源团队协同;
电源需要和液冷团队协同;
网络团队需要和Runtime协同;
Runtime需要理解模型;
模型团队又会反过来要求硬件增加新的功能。
这会造成一个AI系统最常见的工程问题:
每个局部团队都做对了,但整个系统仍然做错了。
例如:
芯片团队把GPU TDP提高20%,获得更高算力。
但Rack电力已经到上限。
于是只能减少每Rack GPU数量。
GPU数量减少以后,Scale-up拓扑改变。
拓扑变化以后模型并行效率下降。
结果:
单GPU性能提高了,
系统性能却未必提高。
这就是为什么AI系统产品定义越来越难。
局部最优,不等于全局最优。
十七、真正稀缺的能力开始变成"复杂工程组织能力"
这可能是AI芯片行业接下来最容易被低估的一项竞争力。
一家企业可以招到优秀GPU架构师。
也可以买到高速SerDes IP。
可以找到服务器ODM。
可以买交换芯片。
可以买液冷设备。
但最困难的问题是:
谁来决定整个系统应该是什么?
模型需要什么?
GPU应该提供什么?
HBM应该配多少?
Scale-up域多大?
网络带宽多少?
Rack功率是多少?
液冷能力多少?
Compiler如何利用硬件?
客户机房能不能部署?
这些决策必须在产品定义早期彼此协调。
等GPU Tape-out以后再发现:
网络不够、
HBM不够、
供电不够、
散热不够,
很多问题已经无法补救。
所以未来大型AI芯片项目真正重要的角色之一,很可能并不只是Chief Chip Architect。
而是:
Chief System Architect。
他的工作不是把某一层做到极致。
而是:
在几十个约束之间找到全局可制造、可部署、可维护、可盈利的平衡点。
十八、这也是为什么芯片创业公司会越来越难
对于创业公司而言,这是一个非常不友好的趋势。
过去设计一颗芯片已经非常昂贵。
现在即使成功流片,还只是开始。
你还需要解决:
板卡;
服务器;
网络;
软件;
机柜;
供电;
散热;
集群验证。
而且这些投入不是简单相加。
它们之间是相互依赖的。
例如你的软件生态不成熟,客户就不愿意部署大量芯片。
客户不愿意规模部署,就无法发现Cluster级问题。
没有规模数据,又很难改善软件和可靠性。
这就是为什么AI芯片正在形成一个越来越强的:
系统生态飞轮。
硬件越多→ 软件优化机会越多
软件越好→ 客户部署越多
部署越多→ 系统问题暴露越充分
系统越成熟→ 客户更敢扩大部署
最终竞争就不再只是:
谁先Tape-out。
而是:
谁先完成从Silicon到Cluster的工程闭环。
十九、但这并不意味着"小公司没有机会"
系统化还有另外一面。
并不是每家公司都必须和NVIDIA一样覆盖整个技术栈。
真正需要回答的问题应该是:
你的产品边界应该画在哪里?
一种公司可能做到Chip。
然后依赖成熟标准和OEM生态。
另一种做到Board。
再一种提供Server Reference Design。
还有公司直接提供Rack-scale系统。
也可能有公司专门针对某一种推理工作负载设计完整Appliance。
真正危险的不是产品边界小。
而是:
你的关键性能依赖于产品边界之外的东西,却没有能力控制它。
比如一颗GPU严重依赖某种特殊Scale-up网络。
那么网络就不能只是客户的问题。
如果性能高度依赖Compiler。
Compiler就不能是第三方适配问题。
如果芯片功率密度必须依赖液冷才能达到标称性能。
那么液冷系统就已经进入产品定义。
所以系统公司的核心原则不是:
什么都自己做。
而是:
把决定最终性能的关键变量纳入可控范围。
二十、系统化还有一个经常被忽略的商业意义
当芯片公司向系统扩展以后,它销售的价值单位也发生了变化。
卖GPU时,很容易比较:
每颗GPU多少钱。
卖Rack以后,可以比较:
每Rack性能。
到了Cluster,则可以比较:
训练时间;
Token吞吐;
Performance per Watt;
Cost per Token。
这实际上改变了竞争维度。
假设A芯片单颗性能比B芯片高20%。
但B系统拥有:
更大的HBM;
更好的互联;
更成熟的软件;
更高的利用率;
更低的故障时间。
最终客户的Cost per Token完全可能出现不同结果。
所以系统化还有一个重要作用:
把竞争从容易比较的芯片参数,移动到更接近客户业务价值的系统指标。
这也是为什么今天越来越多厂商开始讨论:
AI Factory、
Rack-scale Computing、
Tokens per Watt、
Tokens per Dollar。
这不只是营销语言变化。
它反映了真正的产品边界变化。
二十一、NVIDIA和AMD正在展示两种不同的"系统公司"路径
NVIDIA呈现的是一种比较强的纵向整合路线:
GPU;
CPU;
NVLink;
NVSwitch;
ConnectX;
BlueField;
Spectrum-X;
CUDA;
Rack架构,
逐渐形成一套高度协同的计算系统。
AMD则正在尝试另一种模式:
GPU;
EPYC CPU;
Pensando网络;
ROCm,
再结合UALink、Ethernet、OCP以及OEM/ODM合作伙伴形成开放Rack-scale系统。
AMD与Meta在2026年公布的合作甚至明确把联合工程范围描述为Compute、Memory、Networking、Power、Cooling和Software。
值得关注的并不是简单判断哪条路线一定更好。
真正的问题是:
强垂直整合
优势可能是:
跨层优化更彻底;
系统验证边界清晰;
性能更容易形成确定性。
代价可能是:
客户锁定更强;
生态体系更封闭;
供应商替换难度更高。
开放模块化
优势可能是:
供应链灵活;
OEM参与度高;
客户拥有更多选择。
代价可能是:
接口协调更困难;
跨供应商验证成本更高;
局部优化更难形成完整系统收益。
未来AI基础设施很可能长期存在这两种模式之间的拉扯。
二十二、未来判断一家AI芯片公司,应该换一套问题
过去我们习惯问:
什么制程?
多少晶体管?
多少TFLOPS?
HBM多大?
这些问题仍然重要。
但已经不够。
下一代可能更应该问:
第一,它的Scale-up方案是什么?
几十颗GPU如何通信?
第二,它的软件能不能真正把硬件跑满?
不仅仅是能不能运行PyTorch。
而是Kernel、Compiler、Runtime和Collective是否成熟。
第三,它能不能做Rack-scale验证?
不是八卡机器跑通。
而是72卡、几百卡、几千卡以后还能不能稳定运行。
第四,它有没有电源和散热边界意识?
标称性能到底需要什么供电和液冷条件?
第五,它的RAS做到了什么程度?
发生故障以后是整份Job重启,还是能够隔离和恢复?
第六,它有没有成熟供应链?
GPU有货但HBM没有。
HBM有货但先进封装不足。
Rack有了但CDU部署跟不上。
最终都等于没有系统。
第七,也是最重要的:
客户购买的到底是一颗芯片,还是一种确定的计算产能?
如果答案逐渐变成后者,那么系统能力的重要性只会继续提高。
结语:一颗GPU的性能,正在越来越"装不进"一颗GPU里
AI芯片公司为什么正在越来越像系统公司?
因为决定GPU价值的东西,正在不断离开GPU本身。
计算单元太快以后,
瓶颈来到HBM。
HBM解决以后,
瓶颈来到GPU之间的互联。
互联扩大以后,
问题来到网络。
GPU数量增加以后,
功耗来到100kW级Rack。
功耗提高以后,
电源和液冷成为架构问题。
系统扩大以后,
故障和软件调度成为新的瓶颈。
最终你会发现:
所谓AI芯片性能,其实是几十个工程层共同产生的结果。
所以未来真正强大的AI芯片公司,未必是所有环节都自己制造的公司。
但它一定越来越需要具备一种能力:
从模型一路看到电力。
理解模型需要什么;
理解软件怎样映射模型;
理解芯片怎样执行软件;
理解HBM怎样供应数据;
理解网络怎样连接芯片;
理解电源怎样支撑机柜;
理解液冷怎样带走热量;
最终理解整个系统怎样变成客户真正能够购买的计算产能。
过去芯片公司的核心问题是:
"怎样设计一颗更好的芯片?"
AI时代,这个问题正在被重新定义成:
"怎样设计一台由成千上万颗芯片共同组成的计算机?"
这才是AI芯片公司越来越像系统公司的根本原因。
不是因为芯片不再重要。
恰恰是因为芯片太重要、太昂贵、功耗太高,
以至于已经不能再脱离整个系统单独设计。
下一代AI计算真正的竞争单位,
正在从Chip,
走向Board,
走向Server,
走向Rack,
最终走向整个Cluster。
而当这一步发生之后,
芯片公司与系统公司的边界,也会越来越模糊。免责声明:本文采摘自"老虎说芯",仅代表作者观点,如有侵权或异议请联系我们删除。

刚入行先进封装,先别急着背名词
2026-10-14
349
刚进先进封装这一行的时候,很多新人都有一个共同特点:
特别爱背名词。
RDL、TSV、Micro-bump、Hybrid Bonding、FOWLP、2.5D、3D IC、Chiplet……
恨不得入职一个月,就把整张先进封装技术路线图背下来。
这也正常。
刚进一个陌生行业,人总得抓点东西。
名词最容易抓。
看得见,记得住,还显得自己学得快。
但我想跟刚入行的年轻工程师说一句:
先进封装这行,名词真没那么重要。
至少在刚开始的时候,没你想象得那么重要。
我以前见过一个新人,刚入职没多久。
第一次参加早会,会议室大屏一打开,他整个人都懵了。
RDL open、UBM、PI crack、Bump void、Warpage、AOI、SAM、CPK……
一页PPT里,一半是英文,一半是缩写。
他坐在后面,笔记记得特别认真。
哪个缩写什么意思,哪个工艺在哪一步,密密麻麻记了一页。
然后轮到一个异常。
工程师讲了十分钟。
什么线宽偏了,某个位置CD不太稳定,某台设备数据也有一点漂。
大家讨论得挺热闹。
坐在前面的老工程师听了一会儿,最后只问了一句话:
"这个异常到底影响良率吗?"
会议室突然安静了。
有人翻数据。
有人看mapping。
最后发现:
参数虽然漂了一点,但最终电测没明显影响,良率也没掉。
老工程师就说:
"那先别自己吓自己。继续monitor。"
会开完了。
那个新人后来跟我说:
"我准备了一早上的缩写,一个都没用上。"
我说:
"这就对了。"
先别问它叫什么,先问它为什么存在
新人学先进封装,最容易走的一条弯路,就是从名词开始学。
比如学RDL。
一上来就背:
Redistribution Layer,重布线层。
然后开始记线宽、线距、铜厚、介质材料。
这些当然都要学。
但我更建议你先问一个问题:
为什么需要RDL?
如果原来的I/O位置已经够用了,那为什么还要重新布线?
因为很多时候,芯片原本的焊盘位置、间距,跟后面的封装互联方式对不上。
那怎么办?
重新"拉线"。
把原本密集或者位置不合适的I/O,重新分布到更适合后续连接的位置。
你这么一想,RDL一下就活了。
它不再是"课本里的一层金属"。
它是为了解决一个实际问题:
原来的连接方式不够用了。
TSV也是一样。
很多新人第一次学TSV,会记:
Through Silicon Via,硅通孔。
然后开始背孔径、深宽比、刻蚀、绝缘、填铜。
其实你先别急。
先问一句:
为什么非要从硅里面打个孔?
因为有些时候,芯片不能只在平面上连。
你要堆。
你要让上面的Die和下面的Die直接通信。
那横着绕一大圈就太慢、太远了。
怎么办?
直接从硅里面"打通"。
这就是TSV。
一旦你先理解了这个需求,后面的刻蚀、填铜、应力问题,才真正有意义。
否则你只是背工艺。
Hybrid Bonding也是一样。
现在这个词很热。
新人一看资料,第一反应往往是:
"这个是不是比Micro-bump先进?"
这个问题其实不太好。
更好的问题是:
为什么原来的Micro-bump不够用了?
当互联Pitch越来越小的时候,传统凸点会越来越难继续缩。
焊点尺寸、间距、可靠性、寄生参数,都会慢慢碰到边界。
于是大家才开始找更直接的连接方式。
Hybrid Bonding不是因为名字高级才出现。
它是因为前面的方案开始吃力了。
所以我一直觉得:
任何一个先进封装技术,背后都有一个"旧方法快撑不住了"的故事。
你把这个故事找到,技术就容易懂了。
产线上没人因为你会背缩写给你加分
新人刚进厂的时候,经常有一种错觉:
我知道得越多,就显得越专业。
后来你会发现,不是这么回事。
产线最现实。
出了问题,大家只关心几件事:
影响多少片?
影响哪个lot?
良率掉没掉?
能不能继续跑?
根因在哪?
有没有风险扩散?
客户那边会不会出问题?
这个时候,你知道Hybrid Bonding全称是什么,没什么用。
你得知道:
这个异常到底影响什么。
有一次某条线出了个参数漂移。
一个年轻工程师很紧张,说这个参数超过了内部target,建议先停线。
旁边一个老工程师没急着表态。
他先问:
"历史上这个参数漂到这里的时候,良率掉过吗?"
大家查数据。
没有。
他又问:
"后面哪一站会放大这个问题?"
又查。
也没有明显相关性。
然后他说:
"那就别只盯spec,先把correlation做出来。"
这句话我印象很深。
做工程久了你会发现:
参数不是目的,产品才是目的。
RDL线宽也好,bonding pitch也好,warpage也好,最终都得落回产品。
性能有没有提升?
良率有没有影响?
可靠性有没有风险?
成本有没有失控?
这才是真正的工程判断。
先进封装不是"谁懂的名词多"
所以我一直觉得,刚入行前半年,不要把自己搞得太焦虑。
今天看TSV。
明天看FOWLP。
后天又看到玻璃基板。
再过两天行业里又出来一个新词。
你永远追不完。
但底层问题其实就那么几个。
为什么要提高互联密度?
为什么要缩短芯片之间的距离?
为什么要把内存放到计算芯片旁边?
为什么要把一颗大芯片拆成Chiplet?
为什么面积一做大,Warpage就开始麻烦?
为什么Pitch越小,颗粒和对准越来越致命?
你如果把这些"为什么"想明白了,新技术出来的时候,你不会那么慌。
你甚至可以先不认识这个技术名字。
先看它想解决什么问题。
然后你大概就能猜到:
它的代价会在哪里。
我更建议新人养成一个习惯
以后看到一个新技术,先别急着记定义。
先问四句话:
第一,它为什么会出现?
一定是原来的方案有什么地方不够用了。
第二,它到底解决了什么问题?
是带宽?功耗?面积?良率?成本?散热?
第三,它为了解决这个问题,付出了什么代价?
技术从来不是免费的。
互联更密,制造可能更难。
面积更大,翘曲可能更严重。
堆得更高,散热可能更麻烦。
第四,这个代价最后影响良率吗?
这句话特别重要。
因为做到最后,很多先进技术都会回到同一个地方:
Yield。
刚入行的时候,不要急着让自己看起来"什么都懂"。
先进封装跨度太大,没人什么都懂。
你真正应该做的是:
碰到一个问题,就把它追深一点。
为什么这里会开路?
为什么边缘区域比中心差?
为什么reflow之后warpage变大?
为什么换了一批材料,bonding突然不稳定?
为什么某个参数漂了,但良率没掉?
这些问题,比背十页技术路线图有用得多。
等你做久了以后,你会慢慢发现:
你看到一个新技术,第一反应已经不是:
"这个英文缩写是什么意思?"
而是:
"它到底是来解决什么问题的?"
到这个时候,你才算真的开始入门。
所以刚进先进封装这一行,别急。
RDL、TSV、Hybrid Bonding这些东西,早晚都会学会。
先把一个习惯练出来:
看到技术,先问为什么;看到异常,先问影响什么;看到参数,最后一定要落回良率。
这比背多少名词,都重要。免责声明:本文采摘自"老虎说芯",仅代表作者观点,如有侵权或异议请联系我们删除。

国产GPU:原生FP8让Token产量翻倍,收入翻倍
2026-10-14
432
过去几年,评价一张国产 GPU,行业最习惯问的无非几个问题:
能不能跑?
跑得有多快?
和国际主流 GPU 的差距还有多少?
但到了大模型进入规模推理阶段,如果仍然只围绕峰值算力讨论一张 GPU,可能已经不够了。
因为对于真正采购 GPU 的云厂商、模型公司和算力运营商来说,最终需要回答的并不是"这张卡参数有多漂亮",而是一个更现实的问题:
花出去的每一块钱,最终到底能生产多少满足服务质量要求的 Token?
摩尔线程最近发布了一份《MTT S5000 Prefill-as-a-Service 技术白皮书》。
其中一个很有意思的变化是,这份白皮书没有停留在传统的 GPU Benchmark,而是直接开始算一笔"Token 经济账"。
按照白皮书给出的典型 Agent 混合上下文负载假设,单台 8 卡 MTT S5000 的等效 Prefill 吞吐约为 83,670.6 Token/s;再结合 90% Prefix Cache 命中率以及相应 API 价格测算,100% 利用率下,对应的理论月收入约为 56.4 万元。
如果利用率下降至 40%,白皮书给出的名义月收入仍约为 22.6 万元。
当然,这里的"月收入"不是"月利润"。白皮书自己也特别注明,这一测算尚未计入服务器折旧、电费、机房、网络与运维等成本,完整的 TCO 和回本周期仍需要进一步计算。
但恰恰是这种开始谈收入、谈利用率、谈单位 Token 成本的做法,让我觉得比单纯再公布一个峰值算力数字更值得关注。
因为它意味着国产 GPU 的竞争逻辑正在发生变化:
从"参数经济学",逐渐进入"Token 经济学"。
而如果进一步拆解摩尔线程这套方案,会发现背后还有一条更值得讨论的技术主线——
FP8。
一、为什么一张GPU,现在要开始算"Token经济账"?
要理解这笔账,首先要理解今天的大模型推理已经发生了什么变化。
过去的大模型问答,输入可能只有几百、几千 Token。
但 Agent、AI Coding、RAG、长文档分析兴起以后,一次模型调用需要处理的上下文越来越长。
代码文件、历史对话、检索结果、工具调用记录,可能一次性把输入推到数万乃至几十万 Token。
这时候,大模型回答问题的过程,其实可以拆成两个性质完全不同的阶段。
第一个阶段叫 Prefill。
简单理解,就是先把用户提供的大量上下文"读完"。
GPU 会对整个输入 Prompt 进行并行计算,并建立后续生成需要的 KV Cache。
这个过程主要是大规模矩阵运算,因此更偏 compute-bound,也就是吃算力。
第二个阶段叫 Decode。
上下文理解完成以后,模型开始一个 Token 一个 Token 地生成答案。
此时每生成一个新 Token,都要不断读取模型权重以及历史 KV Cache,瓶颈越来越容易转向显存容量和显存带宽,因此更偏 memory-bound。
摩尔线程白皮书将两者概括得很清楚:
Prefill 主要受到浮点算力约束,而 Decode 更多受到显存带宽约束。
问题是,传统推理系统通常让两件事情由同一类 GPU 完成。
于是会出现一个很现实的资源错配。
做 Prefill 时,需要的是高密度算力;
做 Decode 时,更需要大显存和高带宽。
但如果为了同时兼顾两种负载,所有节点都采购同样规格的高端 GPU,就意味着总有一部分昂贵资源没有得到充分利用。
这也是 PD 分离,Prefill-Decode Disaggregation 开始受到越来越多关注的原因。
二、PD分离,本质上是第一次允许GPU"按瓶颈采购"
PD 分离的思想并不复杂:
把 Prefill 和 Decode 拆开。
Prefill 独立组成一个计算资源池;
Decode 独立组成另一个生成资源池。
这样做之后,两边可以分别采购最符合自己工作负载特征的硬件。
Prefill 更看重 FP8 等低精度矩阵计算能力和计算密度;
Decode 则更看重显存容量、显存带宽以及稳定低延迟。
白皮书给出的目标也并不是简单追求一个脱离业务条件的"最高 Token/s"。
Prefill 侧重点是更高的 MFU 和更低的 TTFT;
Decode 侧则需要追求高并发下稳定的 ITL。
最终真正应该优化的是满足服务等级目标之后的有效吞吐,也就是 goodput。
这件事情对数据中心意味着什么?
过去购买 GPU,有点像给所有工作买完全一样的"全能机器"。
PD 分离以后,则第一次可以按照真实瓶颈采购:
计算不够,就增加 Prefill 算力;
显存和带宽不够,就扩 Decode 资源。
于是 GPU 的采购逻辑,也开始从:
"哪张卡综合参数最高?"
变成:
"哪种硬件最适合完成这一段工作,而且单位成本最低?"
这一步非常关键。
因为 AI 基础设施一旦进入规模化阶段,最昂贵的不是某一张 GPU,而是大量 GPU 长期处于低效利用状态。
三、真正决定异构PD能不能成立的,不只是算力,而是KV Cache
如果故事只讲到这里,PD 分离似乎很简单:
Prefill 找一张擅长计算的 GPU;
Decode 找一张擅长显存和带宽的 GPU。
但真正进入工程层面以后,一个更麻烦的问题出现了。
Prefill 算完以后,Decode 怎么接着算?
答案是 KV Cache。
可以把 KV Cache 简单理解成:
大模型读完几十万 Token 的上下文以后形成的一份"中间记忆"。
Decode 接下来每生成一个 Token,都要用到这份记忆。
所以 PD 分离以后,实际上凭空增加了一条新的数据链路:
Prefill GPU → 网络 → Decode GPU。
Prefill 负责生成 KV Cache。
然后通过高速网络,把 KV Cache 送到 Decode 节点。
Decode 再接着生成。
摩尔线程的方案中,S5000 作为 Prefill 计算池,Prefill 产生的 KV Cache 通过 Mooncake Transfer Engine 跨节点传输,并结合 RDMA 等技术减少数据拷贝。
问题也随之而来。
如果 KV Cache 太大怎么办?
网络会不会成为新的瓶颈?
两种 GPU 的数据格式如果不一样怎么办?
是不是还要在中间重新转换一次?
所以,异构 PD 分离真正难的,从来不是:
"两张卡能不能分别算。"
而是:
"两张来自不同计算体系的GPU,算完之后能不能高效率地交接。"
而这正是 FP8 在这套架构中真正开始变得重要的地方。
四、为什么FP8正在从"精度格式",变成AI基础设施的"硬通货"?
过去很长一段时间,大模型训练和推理大量使用 FP16、BF16。
FP16 每个数据元素占用 16 bit。
FP8 则是 8 bit。
最直观的变化就是:
在不考虑 scale、metadata 等额外开销的简化条件下,同样数量的数据,从 FP16 换到 FP8以后,逻辑数据体积大约可以下降一半。
对于短上下文来说,这也许只是一个性能优化。
但进入几十万 Token 的长上下文以后,性质就不一样了。
因为 KV Cache 会随着上下文长度持续增大。
白皮书给出的理论关系显示,KV Cache 容量与模型层数、上下文长度、KV Head 数量、单头维度以及数据元素字节数近似呈线性关系。其中 FP16/BF16 通常按 2 Byte 计算,而 FP8/INT8 是 1 Byte。
所以,上下文越长,数据格式的位宽,就越不只是一个精度问题,而开始成为一个基础设施成本问题。
FP8 的价值至少有三层。
第一层是显存。
相同逻辑数量的 KV 数据,FP8 可以显著降低存储容量需求。
第二层是网络。
PD 分离以后 KV Cache 要跨节点搬运。
数据量越低,同一条高速网络能够承载的请求越多。
而第三层,我认为可能才是这篇白皮书里最值得关注的一层:
异构兼容。
如果 Prefill GPU 输出一种格式,而 Decode GPU 使用另一种格式,中间就必须完成一次数据转换。
这意味着新增 Kernel、新增显存操作、新增延迟,也增加了整个系统的复杂度。
如果是一两张 GPU 做 Demo,这些开销可能不明显。
但如果是一整个在线推理集群,这些额外成本最终都会变成单位 Token 成本。
所以在 PD 分离场景中,FP8 已经不再只是:
"我的 GPU 支持一种更低的计算精度。"
它开始变成异构算力之间的一种数据语言。
五、S5000真正值得看的地方,是硬件级原生FP8
这也是为什么我认为,理解摩尔线程 S5000,不能只盯着 PFLOPS。
按照摩尔线程白皮书给出的定义,S5000 支持 FP8 至 FP64 的完整精度,并且是国产 GPU 中较早支持 FP8 的产品之一。
放在今天的国产通用 GPU 市场里,硬件级原生 FP8 仍然是一项相对稀缺的能力。
但更重要的是:
FP8 只有真正进入完整数据链路,它的价值才会被释放出来。
以 PD 分离为例。
理想情况是:
S5000 完成 Prefill;
生成 FP8 KV Cache;
通过高速互联传输;
Decode 端继续处理。
中间尽可能不再进行格式转换。
摩尔线程白皮书对此写得非常细。
如果 Prefill 和 Decode 两端的 KV Cache 在数据类型、页大小和内存布局等条件上完全一致,就可以走页粒度直传路径,绕过数据类型转换和布局重排;如果数据类型或者布局不同,则仍然需要额外的转换 Kernel。
而真正做到零转换直传,还需要 FP8 的具体格式、scale、KV 页大小、内存布局和元数据等保持一致。
这句话非常重要。
因为它告诉我们:
真正有价值的"原生FP8",并不是规格表里多了一行"支持FP8",而是从计算,到KV Cache,再到网络传输,最后到下一块GPU,整个链路能不能围绕FP8高效率运转。
在半导体行业,这是两个完全不同层次的能力。
"支持一个 Feature",和"围绕一个 Feature 构建出可以生产部署的数据通路",从来不是一回事。
六、为什么FP8对国产GPU还有一层更重要的价值:进入存量算力集群
如果站在客户角度看,这里面还有一个比芯片本身更加现实的问题:
客户机房里的 GPU 已经买了。
服务器已经部署了。
高速网络已经建好了。
推理框架已经调通了。
模型已经上线了。
大量软件和运维体系,也已经围绕现有 GPU 形成。
这时候,如果一家国产 GPU 公司给客户的答案是:
"把原来的系统全部换掉,然后重新建设一套。"
技术上也许能做。
商业决策上却会非常沉重。
因为客户损失的不只是 GPU 本身。
还有已有资产、软件迁移成本、模型适配成本和整个工程体系的切换成本。
这也是为什么我觉得,异构 PD 分离对国产 GPU 的商业意义,很可能比单纯的性能对比更加重要。
它提供了另一种进入数据中心的方式:
不是第一天就要求替代全部 GPU。
而是:
先承接最适合自己的那一部分工作负载。
比如把 Prefill 独立出来。
原来的 GPU 继续承担 Decode。
新的国产 GPU 作为 Prefill 算力池加入。
这时候,FP8 的意义就出现了。
因为异构系统最怕的并不是两张 GPU 性能不同。
真正怕的是:
两个体系之间根本无法低成本地交接数据。
如果 KV Cache 格式能够匹配,高速网络能够直传,同时软件生态又具备较低迁移成本,那么国产 GPU 和现有 GPU 的关系就不一定只能是"二选一"。
它们完全可能出现在同一条推理流水线上。
这可能代表国产 AI 芯片一种非常值得关注的商业化路径:
从"国产替代",走向"国产增量"。
先作为新增资源进入客户已有体系。
再通过实际 TCO 和运行效率,逐渐扩大自己能够承接的工作负载。
某种意义上,这可能比要求客户一次性完成整套基础设施替换,更符合数据中心真实的投资规律。
七、这时候,再看"单台月收入56.4万元",意义就完全不同了
理解了前面的技术逻辑以后,再回头看摩尔线程为什么要给一台 S5000 服务器算"月收入",这笔账就很好理解了。
白皮书设定了一个典型 Agent 混合上下文场景:
约 50% 请求映射至 64K 档;
40% 映射至 200K;
9% 映射至 300K;
1% 映射至 400K。
结合不同长度下测得的 Prefill 性能,得到加权等效吞吐:
83,670.6 Token/s。
按照白皮书采用的定价模型:
缓存未命中输入 Token:8 元/百万 Token;
缓存命中 Token:2 元/百万 Token。
假设 Prefix Cache 命中率达到 90%,那么加权单价变成:
0.1 × 8 + 0.9 × 2
= 2.6 元/百万 Token。
再乘以一个月对应的运行时间:
83,670.6 Token/s× 2.592 百万秒/月× 2.6 元/百万 Token
最终得到:
约56.4万元/月。
这也是为什么"月入 56 万"这个数字看起来很抓眼球。
但从专业角度,必须把它准确理解成:
在特定模型、上下文分布、Cache命中率、API价格和100%利用率假设成立的情况下,一台8卡S5000所提供的Prefill能力,对应约56.4万元/月的理论服务收入。
它不是利润。
也不是固定收益。
更不是买一台机器就自动每个月到账 56 万。
但这个数字仍然很有价值。
因为它第一次把 GPU 从"性能参数"映射到了"商业产出"。
八、我更关注的,其实是国产GPU开始有了自己的"坪效"
商业地产会看坪效。
数据中心会看 PUE。
云计算公司看服务器利用率。
那么 AI 算力最终同样需要一套经济指标:
一台服务器,一个月到底能生产多少有价值Token?
进一步还可以问:
一 PFLOPS 算力每个月创造多少收入?
一千瓦电能转换成多少有效 Token?
一台服务器折旧以后还有多少净贡献?
单位百万 Token 的综合成本是多少?
真正进入产业化阶段以后,GPU 最终一定会面对这些问题。
因为 TFLOPS 和 PFLOPS,本质上只是生产工具的理论能力。
客户真正购买的是生产结果。
就像一家工厂不会永远只比较两台机床的电机功率。
最终一定会比较:
谁单位时间生产的合格产品更多;
谁的设备利用率更高;
谁的单位产品成本更低;
谁的投资回收周期更短。
大模型基础设施也一样。
未来 GPU 真正重要的指标,可能越来越从:
TFLOPS / PFLOPS
转向:
元 / 百万 Token。
以及:
满足 SLO 的 Token / 元。
这也是摩尔线程这份白皮书另一个值得注意的地方。
它甚至进一步尝试定义"单位算力收入":
按照白皮书的 64K 场景测算,单台服务器满载月收入约 64.6 万元,对应单位算力收入约 16.15 万元/PFLOPS/月。
这个指标最终大概率会成为行业标准。
但这种思路本身值得肯定:
国产GPU正在尝试从"性能设备",变成可以计算投入产出比的生产资料。
九、所以,原生FP8真的能让Token翻倍、收入翻倍吗?
这是一个非常容易传播,但也必须讲清楚的问题。
答案不是简单的"是"或者"不是"。
从数据表示的角度看:
FP16 是 16 bit。
FP8 是 8 bit。
在其他条件相同、暂不考虑 scale 和 metadata 的理想情况下,数据体积确实可以接近减半。
这意味着:
同样的显存可以承载更多 KV Cache;
同样的网络可以传输更多数据;
同样时间里可以减少一部分数据搬运压力。
如果原来的系统瓶颈恰好就在这些环节,FP8 就有机会带来非常显著的系统级收益。
但不能简单得出:
"FP8数据减半,所以Token一定翻倍。"
因为一套大模型推理系统最终的吞吐,还受到:
GPU 实际利用率、
Kernel 效率、
Batch Size、
模型结构、
KV Cache 布局、
Prefix Cache 命中率、
网络拓扑、
RDMA 效率、
调度算法、
Decode 侧能力,
等一系列因素影响。
所以我更愿意把原生 FP8 的价值描述成:
它不是让Token和收入自动×2的魔法按钮,但它可能是异构PD架构释放Token产能与经济性的一个关键"效率开关"。
这两种说法看起来只差一点。
实际代表的是完全不同的技术理解。
十、为什么这件事对国产GPU尤其重要?
过去国产 GPU 的竞争,经历了几个阶段。
第一阶段是:
能不能做出来。
第二阶段是:
能不能把大模型跑起来。
第三阶段是:
性能、软件生态和稳定性到底做到什么程度。
而进入推理基础设施时代以后,我认为会出现第四个维度:
谁能够用最低的切换成本,进入客户已经存在的算力体系?
这也是我认为 S5000 原生 FP8 值得重点观察的真正原因。
它背后连接的不是孤立的一个 FP8 参数。
而是一整条产业链:
FP8计算 → KV Cache → 高速互联 → PD分离 → 长上下文 → Agent → Token经济账。
把这条链条连起来以后,就会发现,摩尔线程此次真正想解决的问题,并不是:
"国产 GPU 能不能也支持 FP8?"
而是:
"国产GPU能不能使用主流AI基础设施已经采用的数据方式,成为现有推理集群的一部分?"
如果这个问题能够持续得到客户侧和规模部署的验证,它的价值可能远比某一次单卡跑 分更大。
因为对于数据中心来说,真正昂贵的从来不是一张 GPU。
而是整个系统迁移和资产重构的成本。
十一、真正的经济账,其实还差最后半张表
当然,现在还不能仅仅看到 56.4 万元/月,就直接得出投资回报率已经被完全算清楚。
因为白皮书当前主要解决的是 Revenue,也就是收入端。
真正完整的经济账,还应该继续减去:
服务器采购成本;
400G 网络与交换设备;
GPU 功耗;
CPU、内存及整机功耗;
IDC 机房成本;
运维成本;
设备折旧;
软件和模型适配成本。
同时还要考虑真实业务中不可能长期维持 100% 利用率。
Prefix Cache 命中率也可能发生变化。
异构 PD 还会受到 KV Cache 传输、混合请求调度、在途显存占用以及跨节点 Prefix Cache 命中率等因素影响。
白皮书也明确提醒,这些因素都可能使实际吞吐低于理论估计。
所以,我更期待摩尔线程下一步把这张表继续向下算。
比如:
月度Token收入
减:
折旧 + 电费 + IDC + 网络 + 运维
等于:
月度净贡献。
然后再进一步:
服务器采购成本 ÷ 月度净贡献
等于:
静态投资回收周期。
如果这张表最后能够在真实客户业务中跑通,那么国产 GPU 才真正完成了一次很重要的身份转变:
从芯片产品,走向生产资料。
结语:国产GPU下一场竞争,可能不再是谁的参数表更漂亮
我一直觉得,判断一个硬科技产业是否真正进入商业化阶段,有一个很有意思的观察指标:
厂商什么时候开始愿意讨论成本,而不仅仅讨论性能。
性能解决的是:
能不能上牌桌。
成本解决的是:
客户会不会买。
而 ROI 最终决定的是:
客户会不会持续采购,并且扩大部署。
从这个角度看,摩尔线程这次围绕 S5000 提出的 Prefill-as-a-Service 和 PD 分离,并不是简单多做了一个性能测试。
它实际上正在尝试回答一个更接近产业化的问题:
在真实的大模型推理基础设施里,一张国产GPU到底能够创造多少有效Token,它能不能以更合适的成本进入客户已经存在的算力体系?
原生 FP8 在这里,也就不再只是规格表里的一行技术参数。
它一头连接着高密度低精度计算;
一头连接着越来越庞大的 KV Cache;
中间是高速互联;
后面则连接 PD 分离、Agent 和长上下文。
最终,所有这些技术问题都会落到一张经济报表上:
每个月能生产多少Token?
每百万Token成本多少?
资产利用率多少?
多久能够回本?
所以,与其简单说:
"原生 FP8 让 Token 产量翻倍、收入翻倍。"
我更愿意把这件事理解为:
原生FP8正在成为国产GPU参与下一代异构AI基础设施竞争的一张重要入场券。
数据位宽可以减半。
但真正有价值的,是它是否能够进一步把 KV Cache 搬运、异构协同、算力利用率和客户已有资产全部串起来。
如果这条链条最终能够在越来越多真实生产环境中成立,那么国产 GPU 下一阶段竞争的核心,也许真的不再只是"谁的峰值性能更高"。
而是谁能让客户用同样一块钱,
生产出更多满足SLO的Token。
这,才是大模型推理真正的经济账。免责声明:本文采摘自"老虎说芯",仅代表作者观点,如有侵权或异议请联系我们删除。

HBM 为什么这么难做?真正的核心工艺,不只是“把 DRAM 叠起来”
2026-10-14
511
HBM 为什么这么难做?真正的核心工艺,不只是"把 DRAM 叠起来"
AI 芯片火了之后,HBM 也从一个相对小众的存储产品,变成了半导体产业链里的核心环节。
很多人对 HBM 的第一印象是:
把很多颗 DRAM 堆在一起,就变成了 HBM。
这句话不能说错,但只说对了一半。
HBM 真正难的地方,不只是"堆叠",而是要让多层 DRAM 在很小的空间里,实现高密度垂直互连、高带宽传输、低功耗,同时还要解决良率、散热和封装可靠性。
如果把 HBM 的制造过程拆开看,核心其实可以归纳成几个关键词:
DRAM、TSV、减薄、键合、堆叠、先进封装。
一、第一步:先造出高性能 DRAM Die
HBM 的本质仍然是 DRAM。
所以第一步,和普通 DRAM 类似,要先在晶圆上制造大量存储单元。
区别在于,HBM 并不是简单把普通 DRAM 芯片拿来堆。
因为后面还需要做垂直连接,所以 HBM Die 从设计阶段就要考虑:
TSV 的位置
上下层芯片的互连
电源网络
信号完整性
热设计
测试和冗余
可以把普通 DRAM 理解成一栋"平房",数据主要从芯片边缘进出。
而 HBM 更像一栋"高层建筑",不仅要横向布线,还要提前预留大量"电梯井"。
这些"电梯井",就是 TSV。
二、TSV:HBM 最关键的核心工艺之一
TSV,全称 Through-Silicon Via,硅通孔。
这是理解 HBM 最重要的一项技术。
传统芯片之间传输数据,通常要通过封装基板上的线路绕一圈。
而 TSV 的思路是:
直接在硅片上打出垂直通孔,让电信号从芯片正面穿到背面。
于是多层 DRAM 堆在一起后,数据就可以直接上下传输。
可以简单理解成:
text
传统封装:芯片 A ↓封装基板 ↓芯片 BHBM:DRAM │TSV │DRAM │TSV │DRAM
路径更短,也可以一次布置非常多的连接。
这正是 HBM 能做到超宽接口的基础。
TSV 怎么做?
大致需要几个步骤:
在硅晶圆中刻出很深、很窄的孔;
在孔壁形成绝缘层;
填充铜等导电材料;
后续将晶圆减薄;
让 TSV 从晶圆背面露出来。
听起来不复杂,但实际制造非常困难。
因为 TSV 要同时满足:
孔够深、孔径够小、填充完整、电阻够低,而且不能破坏周围的 DRAM 电路。
因此,TSV 本身就是 HBM 成本和技术壁垒的重要来源。
三、晶圆减薄:HBM 为什么可以堆十几层?
如果把十几颗普通厚度的芯片直接叠起来,整个封装会非常厚。
所以 HBM 必须进行一项重要工艺:
Wafer Thinning,晶圆减薄
芯片正面电路完成之后,会把晶圆背面磨掉很大一部分。
把原本较厚的硅片,削薄到非常薄。
这样做有两个目的。
第一,是让整个 HBM Stack 不至于太高。
第二,是把前面制作的 TSV 从背面暴露出来,为上下芯片连接做准备。
但问题也随之而来:
硅片越薄,就越容易翘曲、开裂和损坏。
所以 HBM 堆得越高,对晶圆减薄、临时键合、搬运设备和应力控制的要求就越高。
这也是为什么从 8-Hi 向 12-Hi、16-Hi 演进,并不是简单多放几片 DRAM。
堆叠层数越高,机械和热问题会急剧增加。
四、Micro-bump:让上下两层 DRAM 真正连接起来
TSV 解决的是"穿过芯片"的问题。
但上下两颗芯片怎么接起来?
传统 HBM 通常需要依赖:
Micro-bump,微凸点
可以把它理解成非常微小的金属焊点。
每颗 DRAM Die 上有大量 micro-bump,上下芯片对准之后,通过这些凸点连接。
于是形成:
text
DRAM Die● ● ● ● ← Micro-bump│ │ │ │TSV│ │ │ │● ● ● ●DRAM Die
HBM 的难点在于,这些凸点数量非常多,而且间距越来越小。
因此对:
对准精度
凸点尺寸
焊接质量
翘曲控制
空洞控制
要求都非常高。
只要某些关键连接失效,就可能影响整颗 HBM Stack。
五、Die Stacking:真正把 DRAM "盖楼"
完成 TSV、减薄和 bump 之后,才能进入大家最熟悉的:
芯片堆叠
例如:
text
DRAM │ DRAM │ DRAM │ DRAM │ DRAM │ Base Die
然后形成一个完整的 HBM Stack。
不同产品可能是 8 层、12 层甚至进一步增加堆叠层数。
这里最大的挑战,其实不是"能不能堆起来",而是:
堆完以后还能不能保持高良率。
假设单颗 Die 良率都不错。
但如果需要十几颗 Known Good Die 一起组成一个 Stack,那么任何一层出现严重缺陷,都可能影响整个产品。
所以 HBM 非常依赖:
Known Good Die 测试
冗余设计
Repair 技术
堆叠前筛选
堆叠后测试
这也是 HBM 比普通 DRAM 更贵的重要原因之一。
六、底部的 Base Die,也越来越重要
HBM 最下面通常还有一个非常关键的部分:
Base Die / Logic Die。
它负责连接上面的 DRAM Stack 和外部 GPU。
可以把它理解成整栋 HBM 大楼的一楼大厅:
text
DRAMDRAMDRAMDRAM │Base / Logic Die │GPU
随着 HBM 演进,这颗底层 Die 的作用正在越来越重要。
因为未来 HBM 不只是单纯增加容量,还需要更高的数据传输速度、更复杂的信号和电源管理。
因此 HBM 的发展方向,已经越来越像:
Memory + Logic + 3D Packaging 的结合。
这也是 HBM 与传统 DRAM 最大的产业差别之一。
七、HBM 做完以后,还没有结束:还要和 GPU 封装在一起
HBM Stack 做出来之后,并不能直接插在服务器主板上使用。
它还需要非常靠近 GPU。
因此通常会出现这样的结构:
text
HBM GPU HBM │ │ │══════════════════════════════ Silicon Interposer══════════════════════════════ Package
GPU 和多颗 HBM 被放在同一个先进封装系统中。
中间通过 Silicon Interposer(硅中介层) 或其他高密度互连技术连接。
为什么一定要放这么近?
因为 HBM 的核心思路就是:
不用特别高的单根信号速率,而是用极宽的总线同时传很多数据。
如果距离太远,这么宽的接口就很难实现。
所以今天谈 HBM,其实已经不能只看存储厂。
还必须看先进封装能力。
这也是为什么 AI GPU 供应链中,HBM 和先进封装往往同时成为瓶颈。
八、HBM 最难解决的三个问题
把这些工艺放在一起,就可以理解为什么 HBM 难做。
1. 良率
普通 DRAM 是"一颗芯片坏了,就损失一颗"。
HBM 是十几颗 Die 组成一个复杂系统。
层数越多,对单颗 Die、TSV、bump 和 bonding 良率的要求越高。
2. 散热
HBM 是多层硅片垂直堆叠。
下层产生的热,需要穿过整个 Stack 才能传出去。
而且 HBM 又紧挨着几百瓦甚至更高功耗的 AI GPU。
所以:
HBM 不只是存储问题,同时也是热管理问题。
3. 封装
HBM 的带宽优势,本质上来自巨量并行互连。
这意味着 GPU、HBM、interposer、substrate 必须形成一个非常复杂的整体系统。
任何一个环节出现产能或者良率问题,最终都会限制 AI GPU 出货。
九、一张图看懂 HBM 的核心工艺
如果把整个 HBM 制造流程压缩成一张图,大致就是:
text
DRAM 晶圆制造 ↓TSV 硅通孔 ↓晶圆减薄 ↓Micro-bump / 键合 ↓多层 DRAM Die 堆叠 ↓Base / Logic Die ↓HBM Stack ↓Interposer / 先进封装 ↓GPU + HBM ↓AI Accelerator
所以,HBM 绝不仅仅是一个"更快的 DRAM"。
它实际上同时融合了:
DRAM 制造 + TSV + 晶圆减薄 + 3D 堆叠 + 键合 + 测试 + 先进封装。
写在最后:为什么 HBM 会成为 AI 时代的"兵家必争之地"?
AI GPU 的算力可以不断增加。
但算力越强,就越需要更快地搬运数据。
HBM 的价值,恰恰在于通过 TSV + 3D 堆叠 + 超宽接口 + 先进封装,把大量 DRAM 尽可能贴近 GPU。
因此,HBM 真正的技术壁垒并不只在 DRAM。
更准确地说:
HBM 是存储工艺、3D 集成和先进封装共同形成的一项系统技术。
谁能同时解决更高堆叠、更高良率、更好的散热和更先进的封装,谁才更有机会在下一代 HBM 竞争中领先。

HBM 和 HBF 有什么区别?一个追求“快”,一个追求“又大又快”
2026-10-14
411
HBM 和 HBF 有什么区别?一个追求“快”,一个追求“又大又快”
这两年,AI 芯片火了一个词:HBM。
而最近 Sandisk 又提出了一个很像的新概念:HBF,High Bandwidth Flash,高带宽闪存。
名字只差一个字母,但两者其实不是一类东西。
如果用一句话概括:
HBM 是把 DRAM 做到极高带宽,HBF 是想把 NAND Flash 做到足够高的带宽。
它们解决的,也不是完全相同的问题。
HBM:GPU 身边的“高速工作台”
HBM,全称 High Bandwidth Memory,高带宽内存。
它本质上还是 DRAM,只是通过 3D 堆叠、TSV 等方式,把多层 DRAM 堆起来,并用非常宽的接口和 GPU 连接。
它最大的特点就是一个字:
快。
对于 GPU 来说,HBM 很像摆在手边的高速工作台。
GPU 需要数据时,可以快速拿到,因此特别适合:
AI 训练
高频访问的数据
激活值
KV Cache
各种需要低延迟读写的计算任务
但 HBM 也有缺点:
容量贵。
想把几百 GB、甚至 TB 级模型全部塞进 HBM,成本、功耗和封装难度都会快速上升。
HBF:给 GPU 加一个“超大高速仓库”
HBF 则完全不同。
它不是 DRAM,而是基于 NAND Flash。
大家平时用的 SSD,底层也是 NAND。
问题是,NAND 虽然便宜、容量大,但访问速度和延迟远不如 DRAM。
Sandisk 的思路是:
单颗 NAND 不够快,那就让大量 NAND 同时工作。
通过大量 die 并行、CBA 技术和 3D 堆叠,HBF 希望把 NAND 的总读取带宽提升到 TB/s 级别。
Sandisk 公布的第一代 HBF 目标是:
16 层 die 堆叠
单 stack 容量 512GB
读取带宽 1.6TB/s
Sandisk 希望在接近 HBM 封装尺寸和功耗水平的情况下,获得远高于 HBM 的容量。
这就是 HBF 最吸引人的地方:
它不一定比 HBM 更快,但可能比 HBM 大得多。
HBM 和 HBF,最大的区别是什么?
可以直接看这张表:
对比
HBM
HBF
底层介质
DRAM
NAND Flash
最大优势
低延迟、高带宽
大容量、高带宽
容量
相对较小
很大
延迟
低
明显高于 HBM
写入能力
强
NAND 天生不占优势
成本/bit
高
理论上更低
适合场景
Training、频繁读写
AI Inference、模型权重
技术成熟度
已大规模应用
新技术,仍需验证
这里最容易误解的一点是:
高带宽不等于低延迟。
Sandisk 自己也明确指出,HBF 相比 HBM 仍然有更高的延迟和更大的 page size。
所以即使 HBF 标称 1.6TB/s,也不能理解成:
“HBF 就是一块 1.6TB/s 的 HBM。”
两者的访问方式还是不同的。
为什么 HBF 特别适合大模型权重?
因为 AI 推理中的模型权重有一个特点:
特别大,而且主要是读取。
比如一个 405B 参数模型,如果采用 8-bit 权重,仅模型权重就大约需要 405GB。
这时候,512GB 的 HBF 就很有吸引力。
模型可以长期放在 HBF 里,GPU 需要的时候高速读取,不一定要全部塞进昂贵的 HBM。
这也是为什么 Sandisk 把 HBF 主要定位在 AI inference,而不是 AI training。
Sandisk 的内部 simulation 显示,在 Llama 3.1 405B、8-bit 权重读取场景下,HBF 模型性能与“无限容量 HBM”的差距约为 2.2%。不过需要注意,这只是内部测试和模拟结果,并不是量产产品的完整实测。
所以 HBF 会取代 HBM 吗?
现阶段来看,更可能的答案是:
不会。
更合理的架构可能是:
text
GPU │HBM ← 最快、最常用的数据 │HBF ← 大模型权重、大容量数据 │SSD ← 更大规模的存储
可以把它理解成:
HBM 是 GPU 的“高速工作台”,HBF 是工作台旁边的“超大高速仓库”。
工作台依然需要,因为有些数据必须随手就能拿到。
但如果仓库足够近、搬运速度足够快,就没有必要把所有东西都堆在昂贵的工作台上。
HBF 真正值得关注的,不是“打败 HBM”
Sandisk 给出的目标是,HBF 可以达到 HBM 8~16 倍的容量,同时保持很高的读取带宽。
如果这个思路最终成立,那么 HBF 最大的意义可能不是“替代 HBM”,而是:
在 HBM 和 SSD 之间创造一个新的 memory tier。
未来的 AI 芯片,很可能不是“HBM 还是 HBF”二选一,而是:
HBM + HBF + SSD 一起使用。
HBM 负责最快的数据,HBF 负责超大模型,SSD 负责真正的大规模存储。
对于越来越大的 AI 模型来说,这可能比单纯追求更快的 HBM,更值得关注。免责声明:本文采摘自“老虎说芯”,仅代表作者观点,如有侵权或异议请联系我们删除。

TSV 工艺到底难在哪?一文看懂 HBM 与 3D 芯片背后的“硅中电梯”
2026-10-14
471
TSV 工艺到底难在哪?一文看懂 HBM 与 3D 芯片背后的"硅中电梯"
如果你拆解今天的 HBM、3D DRAM、CIS,甚至很多 Chiplet 和先进封装方案,会反复遇到一个词:
TSV。
TSV 全称 Through-Silicon Via,硅通孔。
它的作用看起来很简单:在硅片内部打出垂直通道,让电信号从芯片正面穿到背面。
但真正困难的地方在于,这并不是"在硅片上钻个孔,再灌点铜"这么简单。
一个合格的 TSV,必须同时解决:
深硅刻蚀;
绝缘;
金属填充;
晶圆减薄;
应力;
热膨胀失配;
电阻、电容;
良率;
后续堆叠和键合。
所以 TSV 本质上不是一个单点工艺,而是一整套 FEOL / BEOL / Packaging 交叉融合的 3D 集成技术。
一、为什么芯片需要 TSV?
传统芯片之间的连接,大多发生在二维平面上。
比如两颗芯片通信,数据通常需要:
text
Chip A ↓焊球 ↓封装基板 ↓走线 ↓焊球 ↓Chip B
问题在于:
距离长,互连数量有限,功耗也比较高。
而如果把芯片垂直堆起来,并且直接"穿过硅片"连接,就可以变成:
text
Die 3 │TSV │Die 2 │TSV │Die 1
这样最大的好处不是"单根线跑得多快",而是:
可以做非常多、非常短的垂直互连。
这就是 TSV 对 HBM 特别重要的原因。
HBM 不是靠几根超高速串行线来获得带宽,而是靠巨量并行接口。
换句话说:
TSV 帮助 HBM 把"高速串行"问题,变成了"超宽并行"问题。
二、TSV 到底长什么样?
可以把 TSV 想象成一根埋在硅里的垂直金属柱。
最简单的结构大概是:
text
上层金属 │ ┌───────────┐ │ Cu │ │ Cu │ │ Cu │ │ Cu │ └───────────┘ 绝缘层 ───────────── Silicon
典型 TSV 往往由几部分组成:
1. Via Hole
也就是在硅中刻出的深孔。
2. Dielectric Liner
在孔壁上覆盖一层绝缘材料。
因为铜不能直接和硅大面积接触,否则会产生漏电和可靠性问题。
3. Barrier Layer
阻挡铜向硅和介质扩散。
4. Seed Layer
为后续铜电镀提供导电基础。
5. Cu Fill
最终把 TSV 填满。
所以 TSV 并不是"一根裸铜柱"。
更接近:
text
Silicon │Insulator │Barrier │Seed │Copper
每一层都影响最终可靠性。
三、第一道难关:怎么在硅里刻出一个又深又直的孔?
TSV 首先要做的事情,是:
Deep Silicon Etch,深硅刻蚀。
通常会使用 DRIE,也就是 Deep Reactive Ion Etching,深反应离子刻蚀。
TSV 的特殊之处在于:
它需要刻得非常深,但孔径又不能太大。
这就引出了一个关键参数:
Aspect Ratio,深宽比
假设一个孔:
text
直径:5 μm深度:50 μm
深宽比就是:
text
50 / 5 = 10:1
如果孔更细、更深,深宽比可能继续上升。
为什么深宽比越高越难?
因为刻蚀过程中必须做到:
孔壁尽可能垂直;
上下孔径一致;
底部不能刻蚀不足;
不能损伤周边器件;
大量 TSV 的深度必须高度一致。
这其实很像挖井。
挖一个宽井不难。
但如果要求:
挖一口几十米深、只有几米宽,而且井壁必须垂直、尺寸还要极其准确。
难度就完全不同。
四、"博世工艺"为什么经常出现在 TSV 里?
深硅刻蚀中经常会提到:
Bosch Process。
它的核心思路是两个步骤不断交替:
text
刻蚀↓侧壁钝化↓再刻蚀↓再钝化↓……
为什么要这么做?
如果只是一味往下刻,等离子体很容易同时侵蚀侧壁,最后得到一个越来越宽的坑。
加入侧壁保护之后,就可以更倾向于:
只向下刻,不向两边扩散。
但 Bosch 工艺也会产生一个典型问题:
Scalloping
即孔壁上出现细小的"波纹"。
类似:
text
│ )│(│ )│(
这些微小侧壁形貌,会影响后续绝缘层、Barrier、Seed Layer 的覆盖均匀性。
因此 TSV 越细、深宽比越高,刻蚀后的侧壁质量就越重要。
五、第二道难关:孔刻出来后,怎么给孔壁穿上"绝缘衣"?
TSV 大多数情况下使用铜作为导体。
但铜不能直接接触硅。
所以刻完孔之后,要先沉积一层:
Dielectric Liner。
常见思路是用 SiO₂ 等绝缘材料。
问题是:
一个深几十微米、直径只有几微米的孔,怎么保证从孔口到孔底都均匀覆盖?
这就是 Conformality,保形性 问题。
假设孔口的膜很厚,但孔底几乎没有覆盖:
text
顶部:████中部:██底部:█
那么后续就容易出现漏电或可靠性问题。
因此 TSV 工艺对沉积设备要求很高。
而且 TSV 越细、越深,越困难。
六、Barrier 和 Seed Layer:铜填进去之前,还要做两层关键结构
绝缘层完成之后,还不能直接灌铜。
通常还需要:
Barrier Layer
Barrier 的作用是:
防止铜扩散。
铜是一种很好的导体,但对半导体器件来说,它也是一种非常"活跃"的污染源。
如果 Cu 扩散进入硅或者介质层,可能影响晶体管可靠性。
所以必须先建立一道防线。
随后还要形成:
Seed Layer
因为后面的铜通常通过电镀生长。
而电镀要求表面首先具有导电能力。
Seed Layer 就像是在孔壁上提前铺一层非常薄的"导电底漆"。
难点依然是:
深孔内部能不能连续、均匀覆盖?
如果 Seed Layer 在某个位置断掉,后续铜就可能无法正常生长。
于是形成 void。
七、第三道大关:怎么把铜完整地填满 TSV?
这是 TSV 制造中非常核心的一步:
Copper Electroplating
也就是铜电镀。
直觉上似乎很简单:
把铜沉积进去,直到孔满。
但实际上,如果上下同时快速生长,很容易出现这种情况:
text
孔口越来越窄↓顶部先封死↓内部留下空洞
最终变成:
text
██████████ ████ 空洞 ████ ██████████
这种缺陷称为:
Void。
更严重的情况还可能出现 seam。
这些缺陷会导致:
电阻升高;
电流集中;
热点;
Electromigration 风险增加;
最终失效。
因此理想状态并不是"从上往下乱长"。
而是尽量实现:
Bottom-up Fill
即:
从底部优先生长,逐渐向上填满。
这涉及复杂的电镀化学体系,包括 accelerator、suppressor、leveler 等添加剂之间的配合。
所以 TSV 的铜填充本身就是一门很深的工艺科学。
八、铜填满之后,为什么还要 CMP?
电镀完成之后,铜不仅进入 TSV 内部,也会覆盖整个晶圆表面。
这时需要进行:
CMP
即 Chemical Mechanical Polishing,化学机械抛光。
它的作用就是把多余铜磨掉,重新得到平坦表面。
最终希望达到:
text
────────────── │ Cu │ │ Cu │ │ Cu │──────────────
而不是:
text
██████████████ ← 多余铜────────────── │ Cu │
CMP 看起来是"磨平",实际上也是高精度工艺。
磨得不够,残铜会短路。
磨得太多,又会出现:
Dishing;
Erosion;
TSV 顶部凹陷。
这些都会影响后续互连。
九、最反直觉的一步:TSV 一开始往往并没有真的"穿透"晶圆
TSV 叫 Through-Silicon Via。
很多人自然会理解为:
一开始就把硅片刻穿。
实际上很多 TSV 工艺并不是这样做。
前期只是刻出一个深孔:
text
晶圆正面 ↓│ TSV ││ TSV ││ TSV ││ ││硅 ││硅 │
孔底下面依然还有硅。
后面再通过:
Backside Thinning
也就是晶圆背面减薄。
把晶圆从几百微米厚慢慢磨薄。
最后:
text
晶圆越来越薄 ↓TSV 底部露出来
这个过程称为:
TSV Reveal
也就是把 TSV 从背面"露出来"。
此时它才真正成为贯穿芯片的垂直通道。
十、为什么晶圆减薄是 TSV 的隐藏难点?
普通硅晶圆本来有一定机械强度。
但 HBM 为了做多层堆叠,需要把 DRAM Die 做得非常薄。
这时候会出现一个问题:
硅片越薄,越容易弯。
甚至像一张很脆的纸。
这会带来:
Wafer warpage;
cracking;
edge chipping;
handling difficulty;
对准困难。
因此实际工艺中,往往需要:
Temporary Bonding
先把器件晶圆临时粘到一片 Carrier Wafer 上。
类似:
text
Carrier Wafer══════════════Adhesive──────────────Device Wafer
然后再对 Device Wafer 做背面研磨、减薄、TSV Reveal。
完成后再把 Carrier 去掉。
所以别看"磨薄"只是一个步骤,它实际上直接关系到:
HBM 能不能继续向 12-Hi、16-Hi 甚至更高堆叠发展。
十一、TSV 最大的材料问题:铜和硅"脾气不合"
TSV 还有一个非常重要、但普通介绍经常忽略的问题:
热膨胀系数不同
Cu 和 Si 在温度变化时,膨胀程度不一样。
简单理解:
text
温度升高↓Copper:想膨胀很多Silicon:膨胀较少
但铜已经被牢牢塞在硅孔里面。
于是就会产生:
Thermo-Mechanical Stress,热机械应力。
这个应力会向 TSV 周围传播。
如果 TSV 离晶体管太近,甚至可能影响器件特性。
因此芯片设计时,TSV 周围往往需要留出一个区域:
Keep-Out Zone,KOZ
也就是:
TSV 附近不要放太敏感的晶体管。
这件事非常重要,因为它意味着 TSV 并不是"免费面积"。
TSV 数量越多,除了 TSV 本身占面积,其周围的应力隔离区也会消耗硅面积。
所以 3D 集成永远存在一个 trade-off:
text
更多 TSV↓更大带宽但同时更多面积+更高应力+更复杂制造
十二、TSV 本身也有电阻和电容
很多人看到 TSV 很短,就会觉得:
这么短的铜柱,电气性能应该近乎完美。
其实不是。
一根 TSV 仍然存在:
text
R —— 电阻C —— 对硅衬底电容L —— 寄生电感
尤其是 TSV 和周围硅之间,会形成寄生电容。
因此:
TSV 不是"理想导线"。
尺寸设计非常讲究。
TSV 做粗一点:
电阻可以下降;
电流承载能力提高;
但同时:
面积变大;
电容可能变化;
Keep-Out Zone 也可能扩大。
做细一点:
密度高;
面积小;
但是:
深孔刻蚀更难;
Barrier / Seed 覆盖更难;
Copper Fill 更难;
电阻增加。
所以 TSV scaling 不是简单地:
越小越先进。
它实际上是一个多变量优化问题。
十三、TSV 越多,HBM 带宽就一定越高吗?
不能简单这么理解。
HBM 的总带宽来自一整条链条:
text
DRAM Cell ↓Local Bitline ↓Peripheral Circuit ↓TSV ↓Base Die ↓Micro-bump ↓Interposer ↓GPU Memory Controller
TSV 只是中间的一段。
所以:
TSV 很宽,并不等于最终 GPU 一定能得到相同规模的有效带宽。
实际还受到:
DRAM bank 并行度;
I/O 速度;
Controller;
Command scheduling;
Bank conflict;
Power;
Thermal;
信号完整性;
等因素限制。
这也是分析 HBM 时必须区分:
Physical Interconnect Capability
和
System Effective Bandwidth
的原因。
十四、Via-First、Via-Middle、Via-Last 有什么区别?
按照 TSV 在半导体制造流程中什么时候做,可以大体分成三类。
Via-First
在晶体管制造之前做 TSV。
优点是后续整合比较直接。
缺点是:
TSV 材料必须经受后续非常高温的前道工艺。
因此材料选择受到很大限制。
Via-Middle
晶体管完成后、部分金属互连阶段做 TSV。
这是很多 3D 集成中非常重要的路线。
好处是:
不需要经历全部最高温 FEOL;
TSV 尺寸可以做得相对小;
与芯片互连整合较好。
Via-Last
等芯片大部分工艺都完成之后,再制作 TSV。
好处是:
对原有 CMOS 制程干扰较小。
但是 TSV 往往需要穿过更多结构,工艺整合难度也不同。
可以简单记住:
| 类型 | TSV 什么时候做 | 特点 || ---------- | ----------- | --------- || Via-First | 晶体管之前 | 高温兼容要求高 || Via-Middle | 晶体管之后、金属互连中 | 密度与整合能力较强 || Via-Last | 大部分芯片完成后 | 更偏后段整合 |
没有一种路线绝对最好。
关键取决于产品架构和 fab / packaging flow。
十五、TSV 和 Micro-bump 是一回事吗?
不是。
这是一个很常见的误区。
TSV 是:
穿过一颗 Die 内部的垂直连接。
Micro-bump 是:
连接两颗 Die 的界面。
所以完整路径通常类似:
text
Die 2 │TSV │Micro-bump │Die 1 │TSV
可以把 TSV 想象成:
大楼内部的电梯井。
而 micro-bump 更像:
两栋结构之间的连接门。
两者作用不同,但共同构成 3D 芯片的垂直互连网络。
十六、那 Hybrid Bonding 会不会取代 TSV?
这里也很容易产生误解。
Hybrid Bonding 主要解决的是:
Die-to-Die 或 Wafer-to-Wafer 界面的高密度连接。
它可以减少甚至取消传统 micro-bump。
但它并不意味着 TSV 自动消失。
例如:
text
上层 Die ↓Hybrid Bond ↓下层 Die ↓TSV ↓Package
如果信号最终还需要从硅片一侧传到另一侧,依然可能需要 TSV。
因此更准确的理解是:
Hybrid Bonding 主要挑战 micro-bump,而不是简单替代 TSV。
未来很多先进 3D 集成反而可能是:
Fine-pitch Hybrid Bonding + Fine TSV
共同使用。
十七、为什么 HBM 越堆越高,TSV 工艺越来越重要?
早期 HBM 堆叠层数比较少。
随着 HBM 向:
text
8-Hi↓12-Hi↓16-Hi
发展,情况会越来越复杂。
因为每增加一层 DRAM,都意味着:
多一层 TSV 路径;
多一次 Die bonding;
更严格的薄化;
更复杂的热路径;
更高的应力;
更困难的良率控制。
假设每颗 Die 都很好,但最终 Stack 有十几层:
任何一个关键缺陷,都可能拖累整个 Stack 的成品率。
因此 HBM 的难度,并不是线性增长。
而更接近:
堆叠越高,制造、热、机械和良率问题相互放大。
这也是为什么高层数 HBM 的壁垒远不只是 DRAM Cell 本身。
十八、TSV 真正的竞争核心是什么?
如果从半导体产业角度看,评价 TSV 技术,不能只看:
"孔能做到多小?"
真正应该同时观察几个指标:
TSV Pitch
TSV 之间能放得多密。
Aspect Ratio
能不能把孔做得又细又深。
Etch Uniformity
整片晶圆上的 TSV 深度是否一致。
Liner / Barrier / Seed Conformality
深孔内部薄膜是否连续。
Void-Free Cu Fill
有没有空洞。
Wafer Warpage
减薄和铜应力之后晶圆会不会严重变形。
Alignment Accuracy
多层堆叠能不能准确连接。
Yield
最后到底能不能规模量产。
所以 TSV 最难的地方从来不是:
做出一颗 demo。
而是:
在整片 300mm 晶圆上制造海量 TSV,并保证每一根都足够可靠,然后还能以较高良率完成后续堆叠。
十九、一张图看懂完整 TSV 工艺
如果把 TSV 制造过程压缩,可以大致理解成:
text
硅晶圆 ↓光刻定义 TSV 位置 ↓DRIE 深硅刻蚀 ↓Dielectric Liner ↓Barrier Layer ↓Seed Layer ↓Cu Electroplating ↓CMP ↓临时键合 Carrier ↓晶圆背面减薄 ↓TSV Reveal ↓背面互连 / Pad ↓Die 切割 ↓Die Stacking ↓Micro-bump 或 Hybrid Bonding ↓3D IC / HBM
只看这一条流程就能发现:
TSV 横跨了:
Lithography、Etch、Deposition、Electroplating、CMP、Wafer Thinning、Bonding 和 Packaging。
这也是 TSV 产业壁垒高的真正原因。
二十、TSV 的本质:把摩尔定律从"横着走"变成"向上走"
过去几十年,半导体提高集成度的主要方式是:
text
晶体管做得越来越小
也就是不断在二维平面上缩小尺寸。
但先进节点越来越昂贵之后,行业开始越来越多地思考:
如果横向缩小越来越难,能不能向上堆?
于是出现:
HBM;
3D NAND;
3D DRAM;
Logic-on-Logic;
Wafer-on-Wafer;
3D Chiplet。
而这些架构都绕不开一个核心问题:
上下芯片之间如何建立足够多、足够短、足够低功耗的连接?
TSV,就是其中最重要的答案之一。
写在最后
如果只用一句话解释 TSV,可以说:
TSV 是在硅中制造垂直电连接,让芯片从二维互连走向真正的三维互连。
但真正理解 TSV 后,会发现它远不只是"打孔"。
它实际上需要同时解决:
深孔刻蚀、绝缘、金属沉积、铜填充、CMP、晶圆减薄、应力、热、可靠性和高精度堆叠。
这也是为什么 HBM 看起来只是"把很多 DRAM 叠起来",实际却拥有如此高的制造壁垒。
DRAM 决定 HBM 能存多少数据,而 TSV 和 3D 封装,很大程度上决定这些数据能否高效地在十几层芯片之间流动。
从这个角度看,TSV 并不是先进封装中的一个配角。
它更像是:
让 3D 芯片真正成为可能的"硅中高速公路"。
免责声明:本文采摘自"老虎说芯",仅代表作者观点,如有侵权或异议请联系我们删除。

为什么AI时代,先进封装突然重要了?
2026-10-14
358
这两年,先进封装突然成了半导体行业的高频词。
Chiplet、HBM、2.5D、3D封装、CoWoS、Hybrid Bonding……
很多人第一次接触这些概念时,会有一个很自然的疑问:
封装以前不就是把芯片包起来吗?为什么现在突然变得这么重要?
如果只是从"封装工艺升级"这个角度去理解,很容易把先进封装看成半导体制造中的一个局部技术。
但实际上,先进封装今天之所以重要,根本原因并不在封装本身。
而在于:
芯片性能继续提升的方法,正在发生变化。
过去几十年,我们主要依靠把晶体管做得越来越小来获得更高性能。
但到了AI时代,仅仅把晶体管继续做小,已经越来越难解决整个系统的问题。
先进封装,正是在这个背景下走到了舞台中 央。
一、过去的芯片升级,核心逻辑其实很简单
过去几十年,半导体产业最经典的发展方式就是:
把晶体管做得更小。
晶体管变小以后,一块同样大的芯片上可以放更多晶体管。
晶体管更多,通常意味着更强的计算能力。
同时,制程不断进步,还可以帮助降低一定的功耗,提高芯片集成度。
所以过去我们讨论芯片性能,最常见的问题就是:
"这颗芯片是几纳米?"
从180nm、90nm、45nm,一路发展到今天的先进制程。
这种思路本质上是在做一件事:
尽可能把更多功能塞进一颗芯片里。
过去,这套方法非常有效。
但问题是,越往先进制程走,难度和成本都在快速上升。
晶体管当然还可以继续缩小,但已经不像过去那样"轻松"。
更重要的是,即使晶体管能够继续缩小,也不代表整个系统的所有问题都会自动解决。
AI芯片就是一个非常典型的例子。
二、AI时代的新问题:芯片"算得快",数据却未必"送得快"
我们平时谈AI芯片,最容易注意的是"算力"。
多少TOPS。
多少TFLOPS。
多少核心。
多少晶体管。
这些指标当然重要。
但是,现代AI计算还有一个同样重要的问题:
数据从哪里来?
一颗GPU真正工作的时候,并不是自己凭空进行计算。
它需要不断从内存中读取数据。
比如模型参数、特征数据、中间计算结果,都要不断在计算单元和存储系统之间移动。
这时候就会出现一个很现实的问题:
GPU的计算速度可以越来越快,但如果数据送不过来,GPU就只能等。
可以把它理解成一家工厂。
工厂里原本有100台机器,后来升级成了1000台高速机器。
机器确实更快了。
但如果原材料还是通过原来的几条小路运进来,那么很快就会出现一个尴尬情况:
机器有能力生产,但原材料供应不上。
这就是现代高性能计算系统越来越重视"带宽"的原因。
而这也是HBM和先进封装越来越重要的直接原因之一。
三、HBM为什么要和GPU放得那么近?
很多人第一次看到AI芯片封装结构时都会发现:
HBM几乎是"贴"在GPU旁边的。
为什么?
为什么不能像普通电脑内存一样,把内存放在稍远的位置?
原因并不复杂。
因为距离越远,数据传输就越困难。
传统方式更多依赖主板上的线路进行数据传输。
但随着AI计算需要的数据量越来越大,仅靠传统互联方式,很难持续满足不断增长的带宽需求。
HBM的思路,则相当于把内存直接搬到了GPU旁边。
这样做有什么好处?
第一,距离更短。
第二,可以提供大量并行的数据通道。
可以继续用高速公路来理解。
传统内存更像是几条速度很高的公路。
而HBM更像是在GPU旁边直接修了一大片多车道高速路网。
不一定要求每一条车道都疯狂提速,但因为车道数量非常多,所以单位时间内能够通过的数据量大幅增加。
这就是为什么HBM特别适合AI和高性能计算。
它真正解决的,不只是"内存更快"。
而是:
让数据能够更高效地送到计算单元。
但这里又出现了一个新问题。
HBM可以靠近GPU,可GPU和HBM并不是直接随便放在一起就行。
两者之间需要大量、高密度、高性能的互联。
这时候,先进封装就真正登场了。
四、为什么传统封装开始"不够用了"?
传统封装时代,封装最重要的任务之一,是保护芯片,并把芯片连接到外部电路。
但到了今天,封装承担的任务已经发生了很大变化。
它不只是"保护芯片"。
还要负责:
把GPU和HBM连接起来;
把多个Chiplet连接起来;
实现高速数据传输;
解决供电问题;
控制信号完整性;
同时还要处理散热和应力问题。
换句话说,过去很多发生在"一颗芯片内部"的连接,现在逐渐开始发生在"封装内部"。
这是一件非常重要的变化。
过去如果想提高系统集成度,我们最直接的办法是:
把更多功能做进同一颗芯片。
而今天,我们开始越来越多地使用另一种方式:
把不同芯片通过高密度封装重新组合成一个系统。
这也是Chiplet兴起的重要背景。
五、为什么不干脆一直做更大的单芯片?
有人可能会问:
既然需要更强算力,为什么不直接做一颗越来越大的GPU?
为什么还要把芯片拆开,再重新封装?
原因之一,是成本和良率。
芯片并不是面积越大越划算。
制造芯片的晶圆上,不可避免会存在一定缺陷。
芯片面积越大,碰到缺陷的概率通常也越高。
如果一颗超大芯片中只有一个关键区域出现缺陷,整颗芯片都可能报废。
而如果把一个大系统拆成几个较小的芯片,也就是Chiplet,就有机会分别制造、筛选,再进行组合。
除此之外,还有另一个问题:
不是所有功能都需要最先进的制程。
例如,一颗高性能芯片中,负责核心计算的部分可能非常需要先进制程。
但某些I/O功能、接口模块、模拟模块,并不一定非要使用同样先进、同样昂贵的制程。
于是就出现了一种新的设计思路:
计算模块用先进制程。
I/O模块可以使用其他成熟制程。
内存由专门的存储工艺制造。
最后再通过先进封装,把这些不同的芯片组合成一个系统。
这就是所谓的"异构集成"。
从这个角度看,先进封装已经不再只是制造后端的一道工序。
它开始参与系统架构本身。
六、先进封装真正接棒的,是"系统性能增长"
所以,如果我们重新回头看今天的先进封装,就会发现一个很有意思的变化。
过去,提升芯片性能最主要的路径是:
把晶体管做小。
而今天,越来越多的性能提升开始来自:
把不同芯片连接得更近、更快、更高效。
这里的核心已经不只是晶体管。
而是系统。
计算单元怎么连接?
存储怎么连接?
不同Chiplet之间怎么通信?
数据怎么移动?
功耗怎么降低?
热怎么导出去?
这些问题开始共同决定一颗高端芯片最终能够做到什么水平。
因此,从更大的视角来看:
先进封装并不是摩尔定律失效后的"补丁"。
它更像是半导体产业从"晶体管缩放"走向"系统缩放"的重要工具。
七、先进封装为什么会越来越重要?
理解了这一点,我们就很容易理解为什么先进封装的战略地位还会继续提高。
因为AI的发展正在同时推动几个趋势:
计算规模越来越大;
内存带宽要求越来越高;
数据搬运量越来越大;
芯片功耗越来越高;
单颗芯片继续做大的成本越来越高。
这些趋势共同指向一个结果:
未来芯片很可能越来越不像"一颗芯片"。
而更像一个小型计算系统。
里面有计算芯片、存储芯片、I/O芯片、各种专用加速模块。
然后通过先进封装,把它们组合起来。
到那个时候,封装做得好不好,直接影响的就不只是芯片是否能够正常工作。
而是:
整个系统能够达到多高的性能。
八、真正值得记住的,不是那些技术名词
所以对于刚开始关注先进封装的人来说,我反而不建议一开始就陷入RDL、TSV、Micro-bump、Hybrid Bonding这些技术细节。
这些技术以后都可以慢慢讲。
更重要的是先记住一条主线:
AI时代,计算能力增长越来越受到"数据搬运"和"系统互联"的限制。
先进封装的价值,就是让多个芯片之间能够像一颗芯片一样,更高效地协同工作。
所以它真正解决的问题,并不是:
"怎么把芯片包装得更高级?"
而是:
当单纯依靠晶体管缩放越来越困难以后,我们还能怎样继续提升整个计算系统的性能?
这才是先进封装真正走到舞台中 央的原因。
也是我们理解Chiplet、HBM、2.5D、3D封装乃至未来更多新技术的起点。免责声明:本文采摘自"老虎说芯",仅代表作者观点,如有侵权或异议请联系我们删除。

什么是玻璃基板?为什么它突然成了先进封装热门方向?
2026-10-14
354
如果把芯片比作一座城市,那么晶体管就是城市里的居民,金属互连是道路,封装基板则像城市的"地基"和"立交桥系统"。
过去很多人谈半导体,只关注芯片本身有多先进,比如多少纳米、多少晶体管。但到了AI芯片、GPU、Chiplet和高性能计算时代,问题变了:单颗芯片越来越大,多个小芯片要拼在一起,HBM高带宽内存要靠得很近,数据要在极短距离内高速传输。这时候,封装不再只是"外壳",而变成了决定芯片性能上限的关键平台。
玻璃基板,就是在这个背景下突然火起来的。
一、玻璃基板到底是什么?
简单说,玻璃基板就是把"玻璃"做成先进封装中的承载和互连平台。
但这里的玻璃,不是窗户玻璃,也不是杯子玻璃,而是经过特殊设计的电子级玻璃材料。它要有很高的平整度、很好的尺寸稳定性、较低的介电损耗,还要能承受后续打孔、金属化、布线、贴装、回流焊等一系列复杂工艺。
如果传统有机ABF基板像一块"高端多层电路板",硅中介层像一块"精密但昂贵的硅桥",那么玻璃基板可以理解成一种新的"高精度、高稳定、低损耗封装地基"。
它的任务不是单纯托住芯片,而是要帮助芯片之间、电源之间、信号之间实现更密、更快、更稳定的连接。
二、为什么先进封装需要新基板?
过去,芯片性能主要靠晶圆制造继续缩小线宽。可是当摩尔定律放慢之后,行业开始走另一条路:把多个芯片拼到一起。
这就是Chiplet思路。
比如一个AI芯片系统里,可能有计算芯片、I/O芯片、HBM内存、缓存芯片、甚至光电模块。它们不是孤立存在的,而是要像一个团队一样协同工作。
问题来了:这些芯片之间要通信,通信就需要"路"。
如果路太窄,数据堵车;如果路太长,延迟上升;如果路太弯,信号损耗变大;如果地基不稳,芯片封装就可能翘曲、开裂、失效。
所以AI/HPC时代,先进封装真正需要的是一个更好的"系统级地基"。
这就是玻璃基板被关注的根本原因。
三、玻璃基板最核心的优势是什么?
第一,是尺寸稳定性好。
有机基板在大尺寸、高温工艺下容易出现热涨缩和翘曲。可以把它想象成一张受热后容易变形的塑料板。对于普通封装来说,这种变形还能接受;但对于超大尺寸AI芯片封装来说,微小变形就可能导致层间对不准、线路失真、焊点应力增加。
玻璃的尺寸稳定性更好,在高温下涨缩更小,更适合做大尺寸、高密度封装的核心材料。
第二,是平整度好。
先进封装里的线路越来越细,就像在一张纸上画头发丝一样细的电路。如果纸面不平,线就容易断、偏、变形。玻璃表面平整,有利于做更精细的RDL重布线和更高密度互连。
第三,是高频低损耗。
AI芯片、数据中心、CPO光电共封装、毫米波通信,都需要高速信号传输。信号跑得越快,对材料损耗越敏感。玻璃具有较好的绝缘性和低介电损耗潜力,适合高频高速场景。
第四,是有机会做更大尺寸封装。
硅中介层精度高,但受晶圆尺寸和成本限制。有机基板成熟便宜,但大尺寸下翘曲和线宽线距存在压力。玻璃基板的吸引力在于:它可能兼具较好的尺寸稳定性、较大的加工面积和更适合面板级制造的潜力。
四、TGV为什么这么重要?
讲玻璃基板,绕不开TGV。
TGV就是Through Glass Via,中文常叫玻璃通孔。它的作用是在玻璃里面打出贯穿上下表面的孔,再把孔金属化,让电信号和电源可以从玻璃的一面传到另一面。
如果没有TGV,玻璃只是一个绝缘支撑板;有了TGV,玻璃才变成一个能做三维互连的封装平台。
可以打个比方:玻璃基板像一栋大楼,RDL是楼层里的横向道路,TGV就是贯穿上下楼层的电梯井。没有电梯井,楼层之间就很难高效连接。
但TGV难就难在,它不是"打个洞"这么简单。
孔要打得准、孔壁要光滑、不能有裂纹,后续还要能镀铜、填孔、平坦化,并且在冷热循环中不能脱落、开裂、失效。单个孔做出来不难,难的是在大面积玻璃上成千上万个孔都稳定做好,而且成本可控、良率足够高。
所以,TGV能力是玻璃基板的基础,但TGV打孔成功不等于玻璃基板量产成功。
五、为什么它突然成了热门方向?
原因可以概括成一句话:
AI算力把先进封装推到了极限,而传统封装基板开始遇到边界。
第一,AI芯片越来越大。GPU、AI ASIC、HBM、Chiplet组合在一起,封装面积不断扩大。面积越大,翘曲越难控制。
第二,芯片之间的数据越来越多。AI计算需要海量数据搬运,芯片之间必须有更高带宽、更低延迟的互连。
第三,信号频率越来越高。高速SerDes、CPO、光电互连、毫米波场景,对低损耗材料的需求越来越强。
第四,成本压力越来越大。硅中介层性能强,但成本高、尺寸受限。玻璃基板如果能走向面板级制造,长期有可能提供新的成本路径。
第五,头部厂商开始推动。当国际大厂开始公开展示玻璃基板、玻璃核心基板和相关封装路线时,产业链自然会开始关注材料、设备、TGV加工、RDL、封测和客户认证机会。
六、它会马上替代ABF和硅中介层吗?
不会这么简单。
玻璃基板的优势很明显,但它不是万能解药。先进封装不是材料单项比赛,而是系统工程。
它要解决的难题包括:玻璃打孔、孔壁清洗、金属化、铜填孔、铜玻璃附着力、RDL细线加工、玻璃搬运、切割、翘曲、热循环、湿热可靠性、封装装配良率和客户认证。
换句话说,玻璃基板不是"材料好,所以一定赢",而是"材料有潜力,但必须通过完整工艺链验证"。
短期看,玻璃基板更可能先在特定高端场景、特定客户、特定封装结构中导入;中长期看,如果良率、成本和可靠性都过关,它才可能成为AI/HPC和Chiplet封装的重要平台之一。
七、怎么看玻璃基板这条路线?
最克制的判断是:
玻璃基板不是简单的概念材料,也不是传统ABF基板的直接替代品,而是先进封装进入AI/HPC时代后出现的一条重要候选路线。
它真正解决的问题,是大尺寸封装、高密度互连、高速低损耗传输和翘曲控制。
它真正的难点,也不在"玻璃能不能用",而在"能不能稳定、低成本、高良率地量产"。
所以,未来观察玻璃基板,不要只看谁说自己会TGV,也不要只看谁有玻璃材料,而要看四个指标:
有没有稳定工艺;有没有客户认证;有没有量产良率;有没有真实订单和收入兑现。
如果这些指标逐步成立,玻璃基板才可能从热门概念,变成先进封装产业链中的真正增量平台。免责声明:本文采摘自"老虎说芯",仅代表作者观点,如有侵权或异议请联系我们删除。

互联芯片相关常见术语
2026-10-14
373
CPU、GPU、内存和网卡再强,也需要高速互联把它们连起来。PCIe 像设备之间的高速公路,CXL 像共享内存仓库的道路,Retimer 像信号中途的整形维修站,SerDes 像把多车道数据压进高速通道的收费口。
你可以把互联芯片理解成:芯片和芯片、服务器和服务器之间的"高速交通系统"——CPU、GPU、内存、网卡、交换机、硬盘都要靠它们传数据。
一、基础概念
互联芯片 Interconnect Chip 负责让芯片、设备、服务器之间高速传数据的芯片,像电子世界的"交通枢纽"。
I/O 芯片 负责输入输出连接的芯片,像一座城市的出入口。
接口 Interface 两个芯片或设备沟通的规则和连接方式,像插头标准。
总线 Bus 多个部件共享的数据通道,像公交线路。
点对点连接 Point-to-Point 两个设备之间直接连接,像两地之间的直达高铁。
协议 Protocol 数据传输时必须遵守的规则,像交通法规。
链路 Link 两个设备之间的数据连接,像一条道路。
带宽 Bandwidth 单位时间能传多少数据,像高速公路有多少车道。
延迟 Latency 数据从一端到另一端需要多久,像快递送达时间。
吞吐量 Throughput 系统实际能传多少数据,像道路实际车流量。
二、PCIe 相关
PCIe 电脑和服务器里最常见的高速连接标准,GPU、网卡、SSD 常靠它连接 CPU。
PCIe Lane 通道 PCIe 的一条数据车道,常见 x1、x4、x8、x16。
PCIe x16 16 条 PCIe 通道,常用于 GPU,像 16 车道高速路。
PCIe Gen3 较早一代 PCIe 标准,速度比后续代际低。
PCIe Gen4 比 Gen3 更快,曾广泛用于服务器和高端 PC。
PCIe Gen5 当前服务器、AI 设备常见高速代际之一。
PCIe Gen6 更高速代际,引入 PAM4 等技术,对信号质量要求更高。
PCIe Switch PCIe 交换芯片,让多个设备共享和扩展 PCIe 通道,像 PCIe 的立交桥。
PCIe Endpoint PCIe 链路末端设备,比如 GPU、网卡、SSD。
Root Complex PCIe 系统里的"总入口",通常在 CPU 或主芯片里,负责管理 PCIe 设备。
三、CXL 相关
CXL 一种基于 PCIe 的新型互联协议,重点解决 CPU、内存、加速器之间的数据共享。
Compute Express Link CXL 的全称,可以理解为"计算设备之间的高速共享通道"。
CXL.io CXL 中负责基础设备管理的部分,类似 PCIe 的传统功能。
CXL.cache 让设备可以访问 CPU 缓存,像让不同部门共享同一份最新文件。
CXL.mem 让 CPU 访问外部设备上的内存,像给 CPU 扩建远程仓库。
内存扩展 Memory Expansion 通过 CXL 给服务器增加更多内存,像给办公室加一个外接仓库。
内存池化 Memory Pooling 多台服务器共享一池内存,像多个工厂共用一个大仓库。
内存一致性 Coherency 多个设备看到的数据要一致,像大家看的都是同一版文件。
CXL Type 1 设备 主要是没有本地大内存的加速器设备。
CXL Type 3 设备 主要是内存扩展设备,像专门外接的大内存仓库。
四、Retimer、Redriver 与信号修复
Retimer 重定时芯片 把变形的高速信号重新整理、重新计时,像给跑乱节奏的队伍重新喊口令。
Redriver 重驱动芯片 增强变弱的信号,像中途给信号加油。
Repeater 中继器 延长信号传输距离,像高速路上的服务站。
Equalizer 均衡器 修正信号失真,像把模糊声音调清楚。
CDR 时钟数据恢复 从高速信号里找回节奏,像从嘈杂音乐里重新找拍子。
Jitter 抖动 信号时间点不稳定,像列车到站时间忽早忽晚。
信号完整性 SI 保证信号传输不失真、不出错,像保证电话声音清楚。
眼图 Eye Diagram 判断高速信号质量的图,开口越大,信号越健康。
误码率 BER 数据传输中出错的比例,越低越好。
链路训练 Link Training 两端设备连接后自动协商最佳传输方式,像两个人先试麦克风。
五、SerDes 与高速物理层
SerDes 串并转换器,把并行数据变成串行高速传输,再变回来,像把多条小路车流合并进高速路。
Serializer 串行器 把多路数据排成一队发出去,像把多列队伍合成一列。
Deserializer 解串器 把一列高速数据拆回多路,像高速路出口分流。
PHY 物理层芯片 负责真实电信号传输的底层芯片,像道路的路面和车道线。
PAM4 一种高速信号方式,用 4 个电平传更多信息,像一辆车一次多装货。
NRZ 较传统的 0/1 信号方式,简单稳定但高速能力有限。
差分信号 Differential Signal 两根线一起传信号,抗干扰更强,像两个人互相校对信息。
通道损耗 Channel Loss 信号经过线路后变弱,像水管越长水压越低。
插入损耗 Insertion Loss 信号经过器件后损失多少,像收费站让车流变慢。
回波损耗 Return Loss 信号被反射回去的程度,像声音遇墙产生回声。
六、以太网与数据中心互联
Ethernet 以太网 数据中心和局域网最常见的网络标准,像互联网世界的普通话。
以太网交换芯片 Ethernet Switch ASIC 交换机里的核心芯片,负责把数据包送到正确端口。
Switch 交换机 数据中心里的交通枢纽,连接服务器、GPU 集群和网络设备。
NIC 网卡 服务器连接网络的设备,像服务器的网络大门。
SmartNIC 智能网卡 带计算能力的网卡,可以分担 CPU 工作,像会自己分拣快递的门卫。
DPU 数据处理器 专门处理网络、安全、存储等数据任务,像服务器里的后勤主管。
RDMA 让一台机器直接访问另一台机器内存,减少 CPU 参与,像仓库之间开直达传送带。
RoCE 基于以太网的 RDMA 技术,常用于 AI 数据中心高速通信。
InfiniBand 高性能计算和 AI 集群常用高速网络,像专用高速铁路。
端口 Port 交换机或网卡上的连接口,像交通枢纽的出入口。
七、GPU、AI 集群互联
NVLink NVIDIA GPU 之间的高速互联,像 GPU 之间的专用高铁。
NVSwitch 连接多颗 GPU 的高速交换芯片,像 GPU 集群里的交通枢纽。
Infinity Fabric AMD 用于芯片内部和芯片间通信的互联技术。
GPU 集群 很多 GPU 连接在一起协同计算,像一支 AI 计算军队。
Scale Up 纵向互联 在一台服务器或一个机柜内把 GPU 高速连起来,像把几个团队合成一个超级团队。
Scale Out 横向扩展 增加更多服务器和 GPU,像多建几座工厂一起工作。
AllReduce 分布式训练中汇总各 GPU 计算结果的操作,像各小组算完后统一对账。
Collective Communication 集合通信 多个计算节点之间一起交换数据,像团队会议同步信息。
通信瓶颈 GPU 算得很快,但数据传输跟不上,像工人很快但物流堵车。
拓扑 Topology 设备之间的连接结构,像城市交通地图。
八、芯粒与片间互联
Chiplet 小芯片 把大芯片拆成多个小芯片再拼起来,像用乐高造芯片。
Die-to-Die 互联 一颗裸片和另一颗裸片之间通信,像两间办公室之间的内部通道。
UCIe Chiplet 之间的开放互联标准,像小芯片之间统一的接口语言。
BoW 互联 Bunch of Wires,一种短距芯片间互联方式,像很多并排小线直接连接。
AIB 互联 Advanced Interface Bus,一类芯粒间互连接口标准。
2.5D 封装互联 多颗芯片并排放在中介层上通信,像几栋楼共用一个大平台。
3D 封装互联 芯片上下堆叠通信,像楼上楼下用电梯直连。
TSV 硅通孔 穿过硅片的垂直连接孔,像芯片高楼里的电梯井。
Interposer 中介层 芯片之间的高速转接平台,像换乘中心。
RDL 重布线层 重新安排芯片接口线路,像重新规划城市道路。
九、存储、硬盘与外设互联
DDR 接口 CPU 和内存之间常见接口,像 CPU 通往内存仓库的道路。
HBM 接口 GPU 和高带宽内存之间的超宽接口,像超宽仓库大门。
LPDDR 接口 手机和低功耗设备常用内存接口,像省电版内存通道。
NVMe 高速 SSD 使用的存储协议,让硬盘更快响应。
SSD 控制器 固态硬盘里的管理芯片,负责读写、纠错和调度。
SATA 较老的存储接口,速度比 NVMe 慢,像旧公路。
USB 控制器 管理 USB 设备连接的芯片,像电脑外设的接待员。
Thunderbolt 高速外设连接技术,可以传数据、视频和供电。
DisplayPort 视频显示接口,常用于显示器连接。
HDMI 常见音视频接口,电视、显示器、显卡都常见。
十、可靠性、安全与产业链
FEC 前向纠错 数据传输时自动纠错,像快递包裹自带校验码。
CRC 校验 检查数据有没有传错,像收货时核对清单。
Hot Plug 热插拔 设备不断电也能插拔,像 U 盘插拔一样方便。
QoS 服务质量 给不同数据流安排优先级,像救护车优先通行。
Flow Control 流控 防止数据发太快把接收端堵住,像交通限流。
Buffer 缓冲区 临时存放数据的地方,像路边临时停车区。
拥塞 Congestion 数据太多导致网络堵车。
互联带宽密度 单位面积或单位端口能提供多少带宽,像一个车站能承载多少客流。
互联功耗 传数据消耗的电。AI 数据中心很关注,因为数据搬运越来越耗电。
互联芯片产业链 包括 SerDes、PHY、Retimer、PCIe/CXL Switch、以太网交换芯片、网卡、DPU、先进封装和高速 PCB 等环节。免责声明:本文采摘自"老虎说芯",仅代表作者观点,如有侵权或异议请联系我们删除。

通俗理解100 个常见 AI 相关术语
2026-10-14
388
一、AI 基础概念
AI 人工智能 让机器像人一样完成理解、判断、生成、决策等任务。
机器学习 Machine Learning 让机器从数据中"总结规律",而不是人手写所有规则。
深度学习 Deep Learning 机器学习的一种,像搭很多层"神经网络积木",适合处理图像、语音、文本。
生成式 AI Generative AI 能生成文字、图片、代码、音乐、视频的 AI,就像"内容生产机器"。
大模型 Large Model 参数很多、能力很强的 AI 模型,好比知识面很广的"超级大脑"。
大语言模型 LLM 专门理解和生成语言的大模型,比如 ChatGPT 这类系统的核心。
基础模型 Foundation Model 先用海量数据训练出来的底座模型,之后可改造成客服、写作、编程等应用。
多模态 Multimodal AI 不只看文字,还能看图、听声音、看视频,像人一样综合理解信息。
自然语言处理 NLP 让机器理解、生成、翻译和总结人类语言。
计算机视觉 CV 让机器"看懂"图片和视频,比如识别人脸、车辆、缺陷、医学影像。
二、模型怎么"思考"和工作
Token AI 处理文字的基本小单位,可以理解为"字词碎片"。你问得越多,用掉的 Token 越多。
Prompt 提示词 你给 AI 下的指令,就像给员工布置任务的说明书。
上下文窗口 Context Window AI 一次能记住和处理的内容长度,好比它的"短期记忆容量"。
推理 Inference 模型训练好以后,真正回答问题、生成内容的过程。
训练 Training 让模型读海量数据、调整内部参数的过程,好比学生刷题学习。
预训练 Pre-training 模型先学习通用知识,就像上基础课。
微调 Fine-tuning 在通用模型上继续训练,让它更适合某个行业或任务。
参数 Parameters 模型内部的"知识旋钮"。参数越多,不一定越聪明,但通常容量更大。
权重 Weights 模型判断时给不同信息的重要程度,好比做决策时的打分权重。
Embedding 向量嵌入 把文字、图片等转成一串数字,让机器能计算"语义距离"。
三、AI 算力硬件
CPU 中 央处理器 电脑的大脑,擅长处理复杂但不一定重复的任务。
GPU 图形处理器 原本用于图形计算,现在非常适合 AI 训练和推理,像一支"并行计算大军"。
TPU Google 为 AI 设计的专用芯片,像专门为深度学习定制的跑车。
NPU 神经网络处理器,常见于手机、PC、边缘设备,用来加速 AI 功能。
ASIC 专用芯片 为特定任务设计的芯片,效率高,但灵活性较低。
FPGA 可以重新配置的芯片,像"可改装的电子积木"。
HBM 高带宽内存 AI 芯片旁边的高速内存,像给 GPU 配的"超宽高速仓库通道"。
DRAM 内存 电脑运行程序时临时存数据的地方,像办公桌。
SRAM 静态存储器 芯片内部更快但更贵的存储,像放在手边的小抽屉。
Chiplet 小芯片 把大芯片拆成多个小芯片拼起来,像搭乐高一样做高性能芯片。
四、AI 数据中心与网络
数据中心 Data Center 集中放服务器、存储、网络设备的大型机房,是 AI 的"工厂"。
服务器 Server 提供计算能力的机器,AI 模型通常跑在很多服务器上。
机柜 Rack 放服务器的柜子,像数据中心里的"货架"。
集群 Cluster 很多服务器连在一起共同工作,像一支计算团队。
Scale Out 横向扩展 增加更多服务器一起干活,像多招人。
Scale Up 纵向扩展 把单台机器或单个节点做得更强,像给一个人升级更强装备。
交换机 Switch 数据中心里的交通枢纽,负责把数据送到正确的服务器。
网卡 NIC 服务器连接网络的接口,像电脑的"网路门"。
光模块 Optical Module 把电信号和光信号互相转换的小设备,是 AI 数据中心高速互联的关键零件。
光纤 Fiber 用光传输数据的线,像数据高速公路。
五、光互联与高速通信
带宽 Bandwidth 单位时间能传多少数据,像高速公路有几条车道。
延迟 Latency 数据从一端到另一端需要多久,像快递送达时间。
吞吐量 Throughput 系统实际处理数据的能力,像工厂实际产量。
400G / 800G / 1.6T 光模块传输速率等级,数字越大,数据高速公路越宽。
DSP 数字信号处理器 光模块里的"信号修复师",让高速传输的信号更稳定。
硅光 Silicon Photonics 用硅芯片工艺做光通信器件,目标是更高集成度、更低功耗。
EML 电吸收调制激光器 高速光模块常用激光器路线,性能强但成本、功耗和封装有压力。
VCSEL 垂直腔面发射激光器 适合短距离传输,像短跑选手,便宜、易阵列化,但远距离和高速上限有限。
LPO 线性直驱光模块 尽量减少 DSP,主要为了降低功耗,像把中间复杂环节省掉。
CPO 共封装光学 把光学部件和交换芯片放得更近,减少电信号损耗,像把仓库建在工厂旁边。
六、AI 模型结构与算法
Transformer 现代大模型的核心架构,擅长处理语言和序列信息。
Attention 注意力机制 让模型判断哪些信息更重要,好比读文章时划重点。
MoE 专家混合模型 模型里有多个"专家",不同问题找不同专家处理,节省算力。
RAG 检索增强生成 先查资料再回答,像开卷考试,能减少胡编。
向量数据库 Vector Database 存放语义向量的数据库,方便 AI 找相似内容。
知识图谱 Knowledge Graph 用点和线表示知识关系,像一张概念关系网。
RLHF 人类反馈强化学习 人给模型反馈,让它回答得更符合人类偏好。
SFT 监督微调 用人工标注的问答样本训练模型,让它更会按要求回答。
蒸馏 Distillation 让小模型学习大模型的能力,像师傅带徒弟。
剪枝 Pruning 删除模型里不重要的部分,让模型更轻、更快。
七、AI 应用与产品形态
AI Agent 智能体 不只是回答问题,还能规划任务、调用工具、执行步骤,像一个数字助理。
Copilot 副驾驶 帮人完成工作但不完全替代人,比如代码副驾驶、办公副驾驶。
Chatbot 聊天机器人 能对话的 AI,常见于客服、助手、问答系统。
AIGC AI 生成内容,包括文章、图片、视频、音乐、代码。
AI 搜索 不只是给链接,而是理解问题、整合资料后给答案。
AI 编程助手 帮程序员写代码、改 Bug、解释代码。
数字人 Digital Human 用 AI 生成外貌、声音和动作的虚拟人物。
自动驾驶 Autonomous Driving 用 AI 感知环境、规划路线、控制车辆。
机器人 Robotics AI 与机械结合,让机器能感知、移动、操作物体。
边缘 AI Edge AI AI 不在云端,而是在手机、汽车、摄像头等本地设备运行。
八、数据、训练和评估
数据集 Dataset 训练 AI 用的资料集合,就像学生的教材和题库。
标注 Annotation 给数据加标签,比如告诉 AI 哪张图里是猫。
训练数据 Training Data 模型学习时使用的数据。
测试数据 Test Data 用来检查模型水平的数据,好比考试卷。
过拟合 Overfitting 模型把训练题背熟了,但遇到新题不会做。
泛化 Generalization 模型遇到新问题也能答得好,说明真的学会了规律。
Benchmark 基准测试 衡量模型能力的标准考试。
准确率 Accuracy 回答正确的比例。
召回率 Recall 该找出来的东西有多少被找出来了,常用于搜索和识别任务。
幻觉 Hallucination AI 一本正经地胡说八道,生成看似合理但实际错误的信息。
九、部署、成本与商业化
API 软件之间调用能力的接口。AI API 就像把模型能力做成"水龙头",别人按量使用。
API 限流 限制用户调用次数,通常说明资源有限或要控制成本。
Token 计费 按输入和输出的 Token 数收费,像按用水量交水费。
推理成本 Inference Cost AI 每回答一次问题所消耗的计算、电力、服务器成本。
训练成本 Training Cost 从零或大规模训练模型的成本,通常非常高。
模型部署 Deployment 把模型真正放到服务器或设备上运行。
云计算 Cloud Computing 通过互联网租用计算资源,不必自己买服务器。
私有化部署 On-premise Deployment 把 AI 系统部署在企业自己的服务器里,更强调数据安全。
SaaS 软件即服务,用户按订阅使用软件,比如在线办公、AI 工具。
算力租赁 不买 GPU,而是按小时或按量租用计算资源。
十、安全、产业和投资常用词
AI 安全 AI Safety 研究如何让 AI 不失控、不误导、不造成伤害。
对齐 Alignment 让 AI 的目标和人类意图一致,避免"答非所问"或错误执行。
隐私保护 Privacy 防止用户数据、企业数据被泄露或滥用。
数据合规 Compliance AI 使用数据时符合版权、隐私、监管要求。
开源模型 Open-source Model 权重或代码公开的模型,方便开发者使用和改造。
闭源模型 Closed-source Model 模型细节不公开,通常由公司通过 API 或产品提供服务。
国产替代 用本土芯片、软件、设备替代进口方案。
AI CapEx 云厂商为 AI 建数据中心、买 GPU、买网络设备的资本开支。
光模块超级周期 AI 数据中心高速互联需求爆发,带动光模块持续升级和放量。
硅光产业链 围绕硅光芯片、激光器、调制器、探测器、封装、光模块形成的产业链,是 AI 数据中心高速互联的重要方向。
一句话理解:AI 不只是一个软件故事,它背后是一整套"数据、模型、芯片、服务器、网络、光模块、电力、散热、应用"的系统工程。
,尽量用普通人能懂的方式解释,适合作为入门词典。
一、AI 基础概念
AI 人工智能让机器像人一样完成理解、判断、生成、决策等任务。
机器学习 Machine Learning让机器从数据中"总结规律",而不是人手写所有规则。
深度学习 Deep Learning机器学习的一种,像搭很多层"神经网络积木",适合处理图像、语音、文本。
生成式 AI Generative AI能生成文字、图片、代码、音乐、视频的 AI,就像"内容生产机器"。
大模型 Large Model参数很多、能力很强的 AI 模型,好比知识面很广的"超级大脑"。
大语言模型 LLM专门理解和生成语言的大模型,比如 ChatGPT 这类系统的核心。
基础模型 Foundation Model先用海量数据训练出来的底座模型,之后可改造成客服、写作、编程等应用。
多模态 MultimodalAI 不只看文字,还能看图、听声音、看视频,像人一样综合理解信息。
自然语言处理 NLP让机器理解、生成、翻译和总结人类语言。
计算机视觉 CV让机器"看懂"图片和视频,比如识别人脸、车辆、缺陷、医学影像。
二、模型怎么"思考"和工作
TokenAI 处理文字的基本小单位,可以理解为"字词碎片"。你问得越多,用掉的 Token 越多。
Prompt 提示词你给 AI 下的指令,就像给员工布置任务的说明书。
上下文窗口 Context WindowAI 一次能记住和处理的内容长度,好比它的"短期记忆容量"。
推理 Inference模型训练好以后,真正回答问题、生成内容的过程。
训练 Training让模型读海量数据、调整内部参数的过程,好比学生刷题学习。
预训练 Pre-training模型先学习通用知识,就像上基础课。
微调 Fine-tuning在通用模型上继续训练,让它更适合某个行业或任务。
参数 Parameters模型内部的"知识旋钮"。参数越多,不一定越聪明,但通常容量更大。
权重 Weights模型判断时给不同信息的重要程度,好比做决策时的打分权重。
Embedding 向量嵌入把文字、图片等转成一串数字,让机器能计算"语义距离"。
三、AI 算力硬件
CPU 中 央处理器电脑的大脑,擅长处理复杂但不一定重复的任务。
GPU 图形处理器原本用于图形计算,现在非常适合 AI 训练和推理,像一支"并行计算大军"。
TPUGoogle 为 AI 设计的专用芯片,像专门为深度学习定制的跑车。
NPU神经网络处理器,常见于手机、PC、边缘设备,用来加速 AI 功能。
ASIC 专用芯片为特定任务设计的芯片,效率高,但灵活性较低。
FPGA可以重新配置的芯片,像"可改装的电子积木"。
HBM 高带宽内存AI 芯片旁边的高速内存,像给 GPU 配的"超宽高速仓库通道"。
DRAM 内存电脑运行程序时临时存数据的地方,像办公桌。
SRAM 静态存储器芯片内部更快但更贵的存储,像放在手边的小抽屉。
Chiplet 小芯片把大芯片拆成多个小芯片拼起来,像搭乐高一样做高性能芯片。
四、AI 数据中心与网络
数据中心 Data Center集中放服务器、存储、网络设备的大型机房,是 AI 的"工厂"。
服务器 Server提供计算能力的机器,AI 模型通常跑在很多服务器上。
机柜 Rack放服务器的柜子,像数据中心里的"货架"。
集群 Cluster很多服务器连在一起共同工作,像一支计算团队。
Scale Out 横向扩展增加更多服务器一起干活,像多招人。
Scale Up 纵向扩展把单台机器或单个节点做得更强,像给一个人升级更强装备。
交换机 Switch数据中心里的交通枢纽,负责把数据送到正确的服务器。
网卡 NIC服务器连接网络的接口,像电脑的"网路门"。
光模块 Optical Module把电信号和光信号互相转换的小设备,是 AI 数据中心高速互联的关键零件。
光纤 Fiber用光传输数据的线,像数据高速公路。
五、光互联与高速通信
带宽 Bandwidth单位时间能传多少数据,像高速公路有几条车道。
延迟 Latency数据从一端到另一端需要多久,像快递送达时间。
吞吐量 Throughput系统实际处理数据的能力,像工厂实际产量。
400G / 800G / 1.6T光模块传输速率等级,数字越大,数据高速公路越宽。
DSP 数字信号处理器光模块里的"信号修复师",让高速传输的信号更稳定。
硅光 Silicon Photonics用硅芯片工艺做光通信器件,目标是更高集成度、更低功耗。
EML 电吸收调制激光器高速光模块常用激光器路线,性能强但成本、功耗和封装有压力。
VCSEL 垂直腔面发射激光器适合短距离传输,像短跑选手,便宜、易阵列化,但远距离和高速上限有限。
LPO 线性直驱光模块尽量减少 DSP,主要为了降低功耗,像把中间复杂环节省掉。
CPO 共封装光学把光学部件和交换芯片放得更近,减少电信号损耗,像把仓库建在工厂旁边。
六、AI 模型结构与算法
Transformer现代大模型的核心架构,擅长处理语言和序列信息。
Attention 注意力机制让模型判断哪些信息更重要,好比读文章时划重点。
MoE 专家混合模型模型里有多个"专家",不同问题找不同专家处理,节省算力。
RAG 检索增强生成先查资料再回答,像开卷考试,能减少胡编。
向量数据库 Vector Database存放语义向量的数据库,方便 AI 找相似内容。
知识图谱 Knowledge Graph用点和线表示知识关系,像一张概念关系网。
RLHF 人类反馈强化学习人给模型反馈,让它回答得更符合人类偏好。
SFT 监督微调用人工标注的问答样本训练模型,让它更会按要求回答。
蒸馏 Distillation让小模型学习大模型的能力,像师傅带徒弟。
剪枝 Pruning删除模型里不重要的部分,让模型更轻、更快。
七、AI 应用与产品形态
AI Agent 智能体不只是回答问题,还能规划任务、调用工具、执行步骤,像一个数字助理。
Copilot 副驾驶帮人完成工作但不完全替代人,比如代码副驾驶、办公副驾驶。
Chatbot 聊天机器人能对话的 AI,常见于客服、助手、问答系统。
AIGCAI 生成内容,包括文章、图片、视频、音乐、代码。
AI 搜索不只是给链接,而是理解问题、整合资料后给答案。
AI 编程助手帮程序员写代码、改 Bug、解释代码。
数字人 Digital Human用 AI 生成外貌、声音和动作的虚拟人物。
自动驾驶 Autonomous Driving用 AI 感知环境、规划路线、控制车辆。
机器人 RoboticsAI 与机械结合,让机器能感知、移动、操作物体。
边缘 AI Edge AIAI 不在云端,而是在手机、汽车、摄像头等本地设备运行。
八、数据、训练和评估
数据集 Dataset训练 AI 用的资料集合,就像学生的教材和题库。
标注 Annotation给数据加标签,比如告诉 AI 哪张图里是猫。
训练数据 Training Data模型学习时使用的数据。
测试数据 Test Data用来检查模型水平的数据,好比考试卷。
过拟合 Overfitting模型把训练题背熟了,但遇到新题不会做。
泛化 Generalization模型遇到新问题也能答得好,说明真的学会了规律。
Benchmark 基准测试衡量模型能力的标准考试。
准确率 Accuracy回答正确的比例。
召回率 Recall该找出来的东西有多少被找出来了,常用于搜索和识别任务。
幻觉 HallucinationAI 一本正经地胡说八道,生成看似合理但实际错误的信息。
九、部署、成本与商业化
API软件之间调用能力的接口。AI API 就像把模型能力做成"水龙头",别人按量使用。
API 限流限制用户调用次数,通常说明资源有限或要控制成本。
Token 计费按输入和输出的 Token 数收费,像按用水量交水费。
推理成本 Inference CostAI 每回答一次问题所消耗的计算、电力、服务器成本。
训练成本 Training Cost从零或大规模训练模型的成本,通常非常高。
模型部署 Deployment把模型真正放到服务器或设备上运行。
云计算 Cloud Computing通过互联网租用计算资源,不必自己买服务器。
私有化部署 On-premise Deployment把 AI 系统部署在企业自己的服务器里,更强调数据安全。
SaaS软件即服务,用户按订阅使用软件,比如在线办公、AI 工具。
算力租赁不买 GPU,而是按小时或按量租用计算资源。
十、安全、产业和投资常用词
AI 安全 AI Safety研究如何让 AI 不失控、不误导、不造成伤害。
对齐 Alignment让 AI 的目标和人类意图一致,避免"答非所问"或错误执行。
隐私保护 Privacy防止用户数据、企业数据被泄露或滥用。
数据合规 ComplianceAI 使用数据时符合版权、隐私、监管要求。
开源模型 Open-source Model权重或代码公开的模型,方便开发者使用和改造。
闭源模型 Closed-source Model模型细节不公开,通常由公司通过 API 或产品提供服务。
国产替代用本土芯片、软件、设备替代进口方案。
AI CapEx云厂商为 AI 建数据中心、买 GPU、买网络设备的资本开支。
光模块超级周期AI 数据中心高速互联需求爆发,带动光模块持续升级和放量。
硅光产业链围绕硅光芯片、激光器、调制器、探测器、封装、光模块形成的产业链,是 AI 数据中心高速互联的重要方向。
一句话理解:AI 不只是一个软件故事,它背后是一整套"数据、模型、芯片、服务器、网络、光模块、电力、散热、应用"的系统工程。免责声明:本文采摘自"老虎说芯",仅代表作者观点,如有侵权或异议请联系我们删除。

通俗理解PCB 相关常见术语
2026-10-14
382
你可以把 PCB 理解成:电子产品里的"城市道路板"——芯片、电阻、电容等元件像城市里的楼房,PCB 上的铜线像道路,负责把电和信号送到正确位置。
一、PCB 基础概念
PCB 印制电路板电子元件安装和互相连接的板子,像电子产品里的"城市道路系统"。
PCBA 电路板组装件PCB 上已经焊好芯片、电阻、电容等元件后的成品,像"道路建好后,楼房也盖好了"。
线路板PCB 的通俗叫法,指带有电路线路的板子。
单面板只有一面有线路的 PCB,像只有一层道路的简单小区。
双面板正反两面都有线路,通过孔连接两面,像上下两层道路有楼梯连接。
多层板PCB 内部有很多层线路,像立体交通网络。
高多层板层数很多的 PCB,常见于服务器、交换机、AI 设备。
HDI 板高密度互连板,线路更细、孔更小,像城市里的密集立交桥。
刚性板 Rigid PCB硬的 PCB,常见于电脑主板、服务器主板。
柔性板 FPC可以弯折的 PCB,像电子产品里的"软排线"。
二、PCB 上游材料
CCL 覆铜板PCB 的核心原材料,可以理解为"带铜皮的基础板材"。
覆铜板基材支撑铜箔和线路的底板,像修路前的地基。
铜箔 Copper Foil覆在板材上的薄铜层,之后会被加工成电路线路。
玻纤布 Glass Fiber Fabric用玻璃纤维织成的布,是 CCL 的骨架,像钢筋混凝土里的钢筋网。
树脂 Resin把玻纤布粘结起来的材料,像混凝土里的水泥。
环氧树脂 Epoxy Resin常见 PCB 树脂材料,FR-4 板里常用。
PP 半固化片 Prepreg半固化的树脂玻纤材料,层压时像"胶水夹心层"。
芯板 Core已经固化好的基础板材,像 PCB 多层结构里的硬骨架。
FR-4最常见的 PCB 材料,性能均衡,像电路板里的"标准水泥路"。
高频材料适合高频信号传输的材料,常用于通信、雷达、射频。
高速材料适合高速数字信号的材料,常用于服务器、交换机、AI 计算设备。
PTFE 材料一种低损耗高频材料,俗称"特氟龙类材料",信号损耗小但加工难。
碳氢树脂材料高频高速板材常用体系之一,适合低损耗信号传输。
陶瓷填料加入树脂中的粉体材料,用来改善介电性能和热性能。
低损耗材料让高速信号少"掉血"的材料,像更平整、更省油的高速公路。
三、关键材料性能
Dk 介电常数影响信号传播速度的材料参数,可以理解为"信号在材料里跑得快不快"。
Df 介质损耗信号在材料中损失多少能量,越低越适合高速通信。
CTE 热膨胀系数材料受热膨胀的程度,不同材料膨胀不一致容易开裂。
Tg 玻璃化转变温度材料从硬变软的关键温度,越高越耐热。
Td 热分解温度材料开始分解的温度,代表耐高温能力。
吸水率材料吸水多少,吸水多会影响绝缘和信号稳定。
耐 CAF 性抗导电阳极丝能力,简单说是防止板内长出"漏电小通道"。
阻燃等级材料防火能力,常见如 UL94 V-0。
导热系数材料传热能力,越高越利于散热。
铜箔粗糙度铜表面的粗糙程度,高速信号更喜欢"平滑道路"。
四、PCB 结构与线路
铜层 Copper LayerPCB 中用来传电和信号的金属层。
信号层 Signal Layer专门走信号的线路层。
电源层 Power Plane给芯片和元件供电的层,像城市供电网络。
地层 Ground Plane提供参考地和屏蔽作用,像电路系统的"稳定底座"。
走线 TracePCB 上的一条铜线路,像道路。
线宽 Trace Width铜线的宽度,影响电流承载和信号质量。
线距 Spacing两条线路之间的距离,太近可能"串线"或短路。
焊盘 Pad元件焊接的位置,像给元件准备的停车位。
过孔 Via连接不同层线路的小孔,像楼层之间的电梯井。
通孔 Through Hole Via从顶层贯穿到底层的孔,像贯穿整栋楼的电梯。
盲孔 Blind Via只从外层连到内部某一层,不贯穿整板。
埋孔 Buried Via藏在 PCB 内部的孔,外面看不见。
微孔 Microvia很小的孔,HDI 板常用,像微型电梯。
背钻 Back Drilling去掉多余孔铜,减少高速信号反射,像把多余岔路封掉。
阻抗控制 Impedance Control控制线路对信号的"道路条件",保证高速信号不乱跑。
五、信号完整性与高速 PCB
高速 PCB用于高速数据传输的 PCB,常见于服务器、AI 加速卡、交换机。
高频 PCB用于高频无线、电磁波、射频信号的 PCB。
信号完整性 SI保证信号传输不变形、不出错,像保证电话声音清楚。
电源完整性 PI保证电源供应稳定,像给城市稳定供电。
EMI 电磁干扰电路产生或受到的电磁噪声,像信号世界里的杂音。
EMC 电磁兼容设备既不干扰别人,也不容易被别人干扰。
串扰 Crosstalk一条线路影响旁边线路,像隔壁房间声音太大。
反射 Reflection信号遇到阻抗不匹配被弹回来,像水波撞墙反弹。
插入损耗 Insertion Loss信号走过线路后损失多少,像车开远了油耗增加。
回波损耗 Return Loss信号反射回去的程度,越低越好。
差分线 Differential Pair两条线一起传信号,一正一反,抗干扰能力强。
单端线 Single-ended Trace一条线传信号,结构简单但抗干扰较弱。
蛇形线 Serpentine Trace弯弯曲曲的走线,用来让不同信号"同时到达"。
等长设计 Length Matching让多条信号线长度接近,像让多辆车同时到终点。
眼图 Eye Diagram检查高速信号质量的图,开口越大说明信号越清楚。
六、PCB 制造工艺
开料 Cutting把大板材切成生产需要的尺寸。
内层线路 Inner Layer Imaging制作 PCB 内部线路,像先修地下道路。
曝光 Exposure用光把线路图形转移到板上,像给电路拍照片。
显影 Developing把需要保留或去掉的图形显现出来。
蚀刻 Etching把多余铜去掉,留下真正的线路。
压合 Lamination把多层材料压成一整块 PCB,像做千层饼。
钻孔 Drilling在板上打孔,用于过孔或插件元件。
沉铜 Electroless Copper在孔壁上沉积铜,让不同层能导通。
电镀 Plating增厚铜层,提高导电能力和可靠性。
图形转移 Pattern Transfer把设计好的电路图转移到实际板材上。
阻焊 Solder MaskPCB 表面常见的绿色保护层,防止短路和氧化。
字符 Silkscreen板子上的白色文字和标记,方便识别元件位置。
成型 Routing把 PCB 加工成最终外形。
V-Cut在拼板上切出 V 形槽,方便后续掰板。
锣板 CNC Routing用数控刀具切割 PCB 外形。
七、表面处理与焊接
表面处理 Surface Finish保护焊盘、方便焊接的工艺。
HASL 喷锡在焊盘上覆盖锡层,便宜常见,但平整度一般。
无铅喷锡 Lead-free HASL不含铅的喷锡工艺,更环保。
ENIG 沉金先镀镍再沉金,表面平整、可靠性好,成本较高。
OSP 有机保焊膜用有机膜保护铜面,成本低但保存和焊接窗口较敏感。
沉银 Immersion Silver表面覆盖银层,导电性好,但容易受环境影响。
沉锡 Immersion Tin表面覆盖锡层,适合部分细间距焊接。
选择性沉金 Selective ENIG只在关键区域做沉金,节省成本。
焊接 Soldering把电子元件固定并连接到 PCB 上。
回流焊 Reflow Soldering通过加热让锡膏熔化,把元件焊到板上。
八、元件安装与组装
SMT 表面贴装技术把小元件贴在 PCB 表面,像把积木贴到板子上。
DIP 插件元件脚插进孔里再焊接,常见于较大元件。
锡膏 Solder Paste焊接用的膏状材料,像"金属胶水"。
钢网 Stencil用来把锡膏印到焊盘上的模板。
贴片机 Pick and Place自动把元件放到 PCB 上的机器,像高速机械手。
AOI 自动光学检测用摄像头检查焊接和元件位置,像给电路板拍照体检。
X-Ray 检测用 X 光检查看不见的焊点,比如 BGA 下面的焊球。
BGA 球栅阵列封装芯片底部布满小焊球,像鞋底布满钉子。
返修 Rework对焊接不良或元件问题进行修复。
ICT 在线测试用测试针检查 PCB 电路是否导通、元件是否正常,像给电路板做电检。
一句话理解:PCB 是电子产品的"地基 + 道路 + 供电网"。CCL 是地基材料,玻纤布是骨架,树脂是胶水,铜箔变成道路,过孔像电梯,阻焊层像保护漆,高速 PCB 则像为 AI 服务器和交换机修的超级高速公路。免责声明:本文采摘自"老虎说芯",仅代表作者观点,如有侵权或异议请联系我们删除。


 粤公网安备44030002007346号